
【SQL文法基礎2】複数のデータを集約して1つにまとめる 〜 集約関数 / GROUP BY / DISTINCT 〜
データ分析でよく使うのがデータの集約です。大量のデータをまとめて確認するのは、データ分析でとても重要なことです。 本章では、月ごとの売上を合計したり、購入者数を集計するために活用される集約関数について学んでいきましょう。
さまざまなデータを処理する関数
関数とは
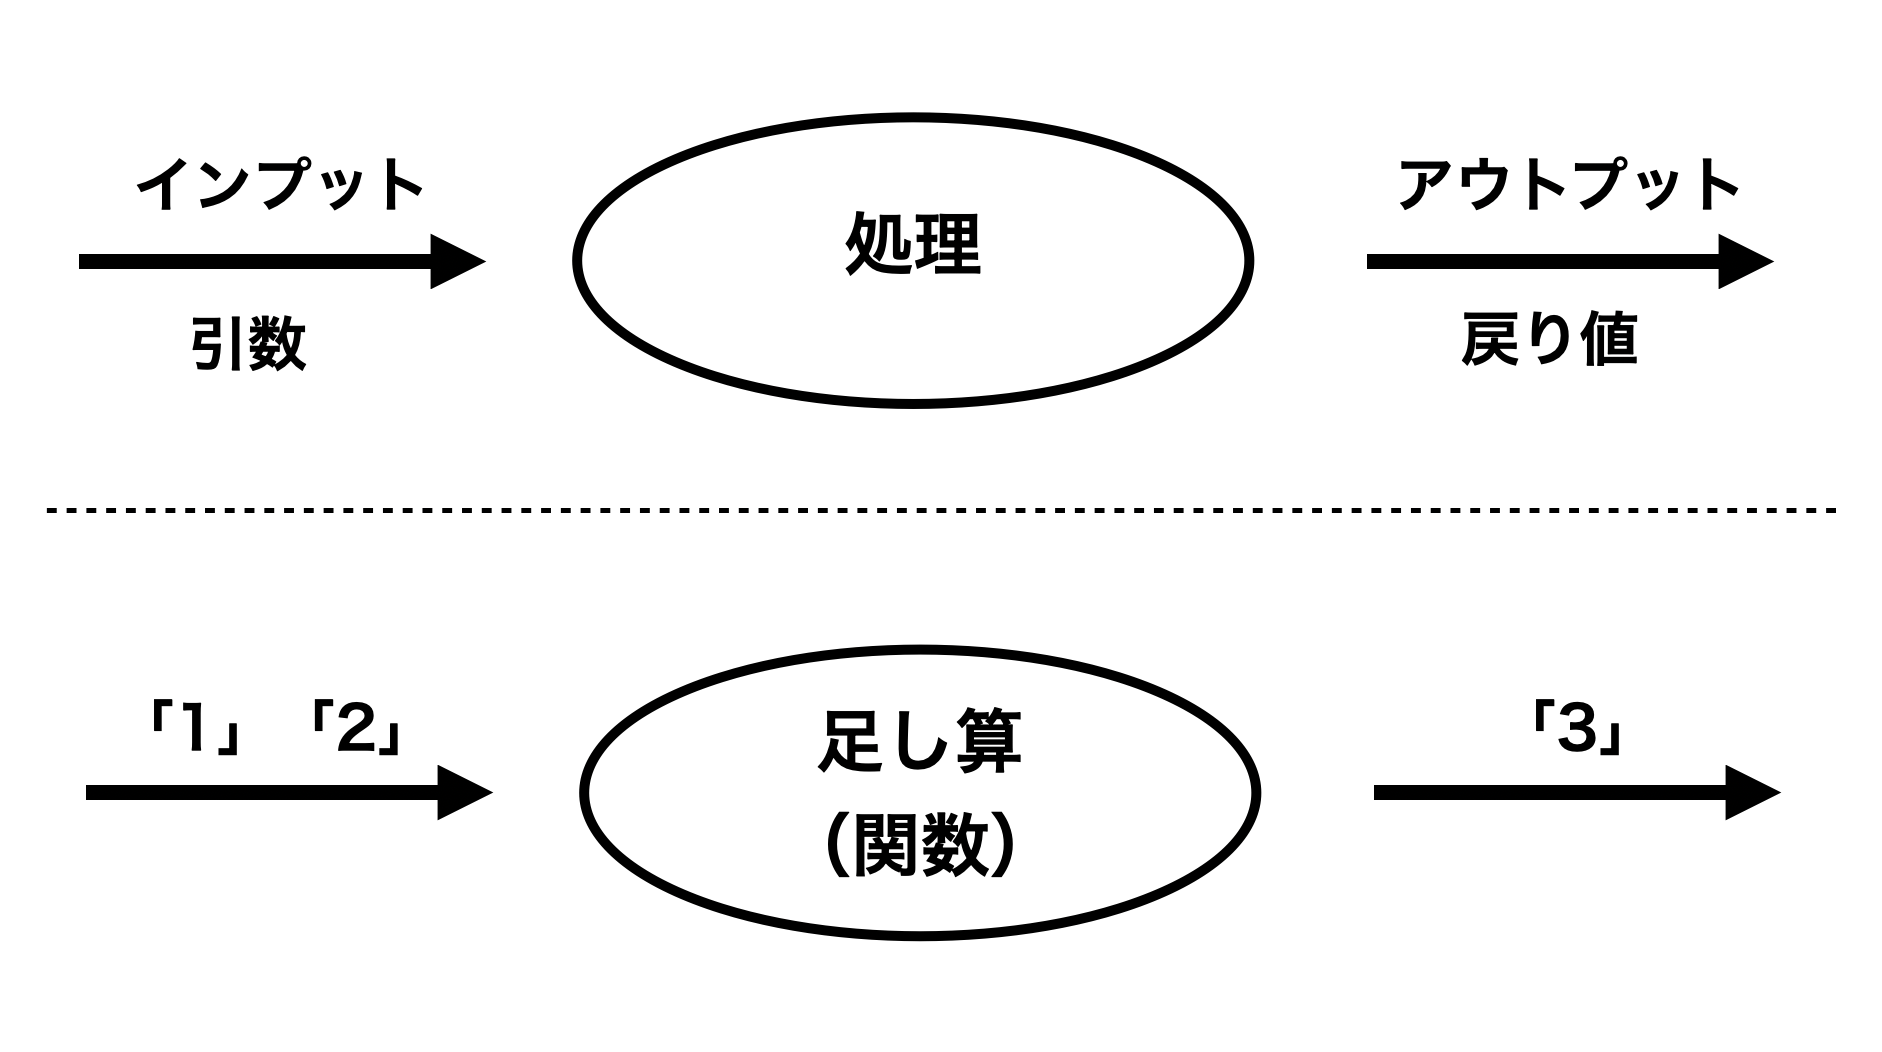
SQLでは、さまざまな観点でデータ分析をするために、関数を活用することが多いです。関数とは、なんらかのデータをインプットすることで特定の結果をアウトプットする処理のことです。インプットとして与えるデータのことを引数、アウトプットとして出力されるデータのことを戻り値と呼びます。
例えば、「たし算」という関数があるとします。数字の「1」と「2」という2つの引数を関数にインプットすることで、戻り値として「3」という値を返します。この「たし算」という処理が関数と呼ばれるものです。
・図4-1:関数とは
SQLで使われる関数
実際にPostgreSQLで使われる関数についていくつか紹介します。関数は非常に多く存在しますが、ここではよく使う関数の一部だけ解説します。
・PostgreSQLでよく使われる関数の一部
関数 | 意味 |
|---|---|
CAST | データの型を変換する |
CURRENT_DATE | 現在の日付を取得する |
SUBSTR | 文字列を切り取る |
CAST
CASTはデータの型を変換する関数です。引数には変換したいカラムと、変換したいデータの型を指定する必要があります。変換したいデータの型はASのあとに指定します。SQL4-1では、CAST(birth_date AS TEXT)と指定しているため、もともと日付(DATE)として定義されていた生年月日(birth_date)を文字列(TEXT)に変換しています。出力結果は、birth_dateもbirth_date_textもどちらも同じ値に見えますが、それぞれデータの型が違います。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-1
SELECT
    birth_date,
    CAST(birth_date AS TEXT) AS birth_date_text
FROM
users・表4-2:SQL4-1の実行結果
birth_date | birth_date_text |
|---|---|
1979-11-04 | 1979-11-04 |
1983-01-24 | 1983-01-24 |
1990-05-08 | 1990-05-08 |
1992-04-05 | 1992-04-05 |
1988-12-04 | 1988-12-04 |
1980-11-24 | 1980-11-24 |
1990-09-03 | 1990-09-03 |
1971-10-14 | 1971-10-14 |
1993-01-01 | 1993-01-01 |
1970-02-07 | 1970-02-07 |
・・・ | ・・・ |
CURRENT_DATE
CURRENT_DATEは現在の日付を返すキーワードです。DATE()のような関数呼び出しとは異なり、カッコをつけずにそのまま記述します。SQL4-2ではCURRENT_DATEと記述することで、現在の日付が取得できます。そのため、結果は2026-05-19のように、SQLを実行した日付が出力されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-2
SELECT
    CURRENT_DATE AS now_date
FROM
users・表4-3:SQL4-2の実行結果
now_date |
|---|
2026-05-19 |
2026-05-19 |
2026-05-19 |
2026-05-19 |
2026-05-19 |
2026-05-19 |
2026-05-19 |
2026-05-19 |
2026-05-19 |
2026-05-19 |
・・・ |
SUBSTR
SUBSTRは文字列を切り取る関数です。SQL4-3では、SUBSTR関数の引数を3つ指定しています。最初の引数に切り取りしたい文字列を指定しています。ここでは、CAST(CURRENT_DATE AS TEXT)で得た2026-05-19(現在の日付の文字列)を切り取る文字列の対象としています。そして、2番目の引数に切り取りを開始する位置、3番目の引数に切り取りする長さを指定しています。つまり、SUBSTR(CAST(CURRENT_DATE AS TEXT), 1, 4)は、2026-05-19という文字列の1文字目から4文字を切り取るため、2026が結果として出力されます。同様に、SUBSTR(CAST(CURRENT_DATE AS TEXT), 6, 2)は2026-05-19という文字列の6文字目から2文字を切り取るため、05と出力されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-3
SELECT
    CURRENT_DATE AS now_date,
    SUBSTR(CAST(CURRENT_DATE AS TEXT), 1, 4) AS year,
    SUBSTR(CAST(CURRENT_DATE AS TEXT), 6, 2) AS month
FROM
users・表4-4:SQL4-3の実行結果
now_date | year | month |
|---|---|---|
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
2026-05-19 | 2026 | 05 |
・・・ | ・・・ | ・・・ |
データベースの違いによる関数の違い
ここで紹介したのは、SQLで使われる関数のごくごく一部です。これ以外にも関数は数多く存在します。また、今回紹介した関数はPostgreSQLで使える関数です。関数は扱うデータベースによって使い方が多少異なります。データベースによっては使える関数、使えない関数もあります。
しかし、SQLで使える関数のすべてを覚える必要ありません。データベースによる違いもすべて覚える必要はなく、必要なときに必要な関数が使えれば問題ありません。本サイトでも、SQLで使える関数が数多く存在するということだけ覚えてもらえれば問題ありません。
関数を使ってデータを集計する
集計に便利な集約関数
SQLで使われる関数の中でも、よく使われるものの1つが集約関数です。集約関数とは複数の行から1つの結果を計算して出力するための関数です。集約関数は、集計関数や集合関数とも呼ばれます。細かい意味の違いはありますが、ほとんど同じものとしてとらえてよいため、本サイトでは集約関数として覚えてもらえれば問題ありません。
では、実際に集約関数について見ていきましょう。本サイトでは、特によく使う5つの集約関数について解説します。
集約関数 | 意味 |
|---|---|
SUM | 引数で指定したデータの総和を求める(NULLの場合は集計対象外) |
MAX | 引数で指定したデータの中から最大値を求める |
MIN | 引数で指定したデータの中から最小値を求める |
AVG | 引数で指定したデータの平均値を求める(NULLの場合は集計対象外) |
COUNT | 引数で指定したデータの総数を求める(NULLの場合は集計対象外) |
SUM
SUMは引数で指定したカラムの総和を求める関数です。SQL4-4では、SUMの引数としてpriceを指定しているので、商品情報テーブル(products)にある商品の金額(price)の合計が出力されます。priceにNULLが含まれる場合は、NULLの行は集計対象から除外されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-4
SELECT
    SUM(price)
FROM
products・表4-5:SQL4-4の実行結果
SUM(price) |
|---|
383577 |
MAX
MAXは引数で指定したカラムの最大値を求める関数です。SQL4-5では、MAXの引数としてpriceを指定しているので、商品情報テーブル(products)にある商品の金額(price)の中で最も高い金額が出力されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-5
SELECT
    MAX(price)
FROM
products・表4-6:SQL4-5の実行結果
MAX(price) |
|---|
35000 |
MIN
MINは引数で指定したカラムの最小値を求める関数です。MAXの反対を意味しています。SQL4-6では、MINの引数にpriceを指定しているので、商品情報テーブル(products)にある商品の金額(price)の中で最も低い金額が出力されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-6
SELECT
    MIN(price)
FROM
products・表4-7:SQL4-6の実行結果
MIN(price) |
|---|
59 |
AVG
AVGは引数で指定したカラムの平均値を求める関数です。AVGはAVERAGEの略です。SQL4-7では、AVGの引数としてpriceを指定しているので、商品情報テーブル(products)にある商品の金額(price)の平均値が出力されます。priceにNULLが含まれる場合は、NULLの行は集計対象から除外されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-7
SELECT
    AVG(price)
FROM
products・表4-8:SQL4-7の実行結果
AVG(price) |
|---|
6392.95 |
COUNT
COUNTは引数で指定したカラムの総数を求める関数です。テーブルにあるデータの行数を数えるときに活用されます。SQL4-8では、COUNTの引数にproduct_idを指定しているので、商品情報テーブル(products)にある商品ID(product_id)の行数が出力されます。product_idにNULLが含まれる場合は、NULLの行は集計対象から除外されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-8
SELECT
    COUNT(product_id)
FROM
products・表4-9:SQL4-8の実行結果
COUNT(product_id) |
|---|
60 |
COUNTを使ったデータの集計
集約関数のCOUNTを使うとテーブルにあるデータの行数を集計することができます。このとき、COUNTの使い方にはいくつかパターンがあります。
まずはSQL4-9を実行して出力結果を確認してみましょう。SQL4-9では、COUNTを使って3つの集計を行っています。COUNTの引数として「1」やアスタリスク(*)を入れることで、テーブルにあるデータの行数を集計することができます。
しかし、COUNT(user_id)のようにCOUNTの引数にカラム名を入れた場合と、「1」やアスタリスク(*)を入れた場合では、微妙に集計方法が異なります。COUNTの引数にカラム名を入れた場合、そのカラムの値にNULLが入っていると行数の集計から除外されます。SQL4-9で使っているuser_idには、一部NULLが含まれているため、結果としてはテーブルにあるすべての行数を集計したときよりも少なくなります。
また、第3章の「さまざまなデータの取得方法」で解説したように、SELECTした結果はASを使って別名をつけることができます。集約関数の結果に関しても、COUNT(user_id) AS user_id_countのようにASを使って別名をつけることで、出力される結果のカラムはuser_id_countとなります。集約関数の結果にASを使わないと、COUNT(*)やCOUNT(1)のように、出力される結果のカラムが集約関数のままになります。
このように、集約関数の結果にASを使わないと、結果の解釈が難しくなることがあります。集約関数を使うときは必要に応じてASを使い、どんな集計をしているのかわかりやすくしましょう。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-9
SELECT
    COUNT(user_id) AS user_id_count,
    COUNT(*),
    COUNT(1)
FROM
orders・表4-10:SQL4-9の実行結果
user_id_count | COUNT(*) | COUNT(1) |
|---|---|---|
100000 | 100000 | 100000 |
複数のデータを特定の切り口でまとめる
特定の切り口でデータを集計する
データ分析では、商品のカテゴリごとの件数を集計したり、売上を日別に合計したり、特定の切り口でデータを集計する方法がよく使われます。その時に活用するのがGROUP BYです。GROUP BYと集約関数を活用することで、特定の切り口でデータを集約することができます。
SQL4-10、SQL4-11を実行して出力結果の違いを確認してみましょう。SQL4-10は、COUNTを使って商品情報テーブル(products)の行数を集計しています。一方でSQL4-11は、同じくCOUNTを使って商品情報テーブルの行数を集計していますが、GROUP BYが使われています。GROUP BY large_categoryと記述することで、大カテゴリ(large_category)単位でグルーピングして集計できるようになります。
このように、GROUP BYを使うと、特定の切り口でデータを集約できます。また、SQL4-11のようにGROUP BYで指定したlarge_categoryは、SELECTのあとに記述することで、カテゴリ情報と行数の2つが出力されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-10
SELECT
    COUNT(*)
FROM
products・表4-11:SQL4-10の実行結果
COUNT(*) |
|---|
60 |
・SQL4-11
SELECT
    large_category,
    COUNT(*)
FROM
    products
GROUP BY
large_category・表4-12:SQL4-11の実行結果
large_category | COUNT(*) |
|---|---|
インテリア | 4 |
ファッション | 6 |
日用品 | 34 |
電化製品 | 9 |
食品 | 7 |
SELECTとGROUP BYをセットで使う
基本的にGROUP BYで指定したカラムは、SELECTのあとにも入れることが多いです。しかし、GROUP BYで指定したカラムをSELECTのあとに入れなくても、SQLの構文として成り立ちます。
違いについて理解するために、SQL4-12を実行して出力結果を確認してみましょう。SQL4-12の出力結果を見ると、GROUP BYで大カテゴリ(large_category)単位の行数を集計しているので、結果として大カテゴリごとの件数が出力されます。ただし、SELECTに指定しているのがCOUNT(*)だけなので、出力結果として表示されるのもCOUNTを使って集計した件数だけになります。この場合、どのカテゴリが何件あるのかがわからなくなるので、SQL4-11のようにGROUP BYで指定したカラムは、SELECTの中でも指定することが多いです。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-12
SELECT
    COUNT(*)
FROM
    products
GROUP BY
large_category・表4-13:SQL4-12の実行結果
COUNT(*) |
|---|
4 |
6 |
34 |
9 |
7 |
複数の切り口でデータを集計する
特定の切り口でデータを集約するGROUP BYでは、複数のカラムを指定できます。
SQL4-13を実行して出力結果を確認してみましょう。SQL4-13では、GROUP BYに大カテゴリ(large_category)と中カテゴリ(medium_category)の2つのカラムを指定しています。SELECTにもlarge_categoryとmedium_categoryを指定し、COUNT(*)で大カテゴリと中カテゴリを組み合わせて行数を集計しています。
このように、GROUP BYはカンマ区切りで複数のカラムを指定することで、それぞれを組み合わせてデータを集約することができます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-13
SELECT
    large_category,
    medium_category,
    COUNT(*)
FROM
    products
GROUP BY
    large_category,
medium_category・表4-14:SQL4-13の実行結果
large_category | medium_category | COUNT(*) |
|---|---|---|
インテリア | 家具 | 4 |
ファッション | アクセサリー | 1 |
ファッション | カバン | 1 |
ファッション | シューズ | 1 |
ファッション | 衣服 | 3 |
日用品 | キッチン | 14 |
日用品 | 文房具 | 9 |
日用品 | 美容 | 11 |
電化製品 | ゲーム | 2 |
電化製品 | 娯楽 | 2 |
・・・ | ・・・ | ・・・ |
重複を排除してデータを集計する
DISTINCTを使った重複排除
データ分析では、同じデータが含まれている場合、重複を排除して集計するのか、排除せずに集計するのかという観点も重要になります。
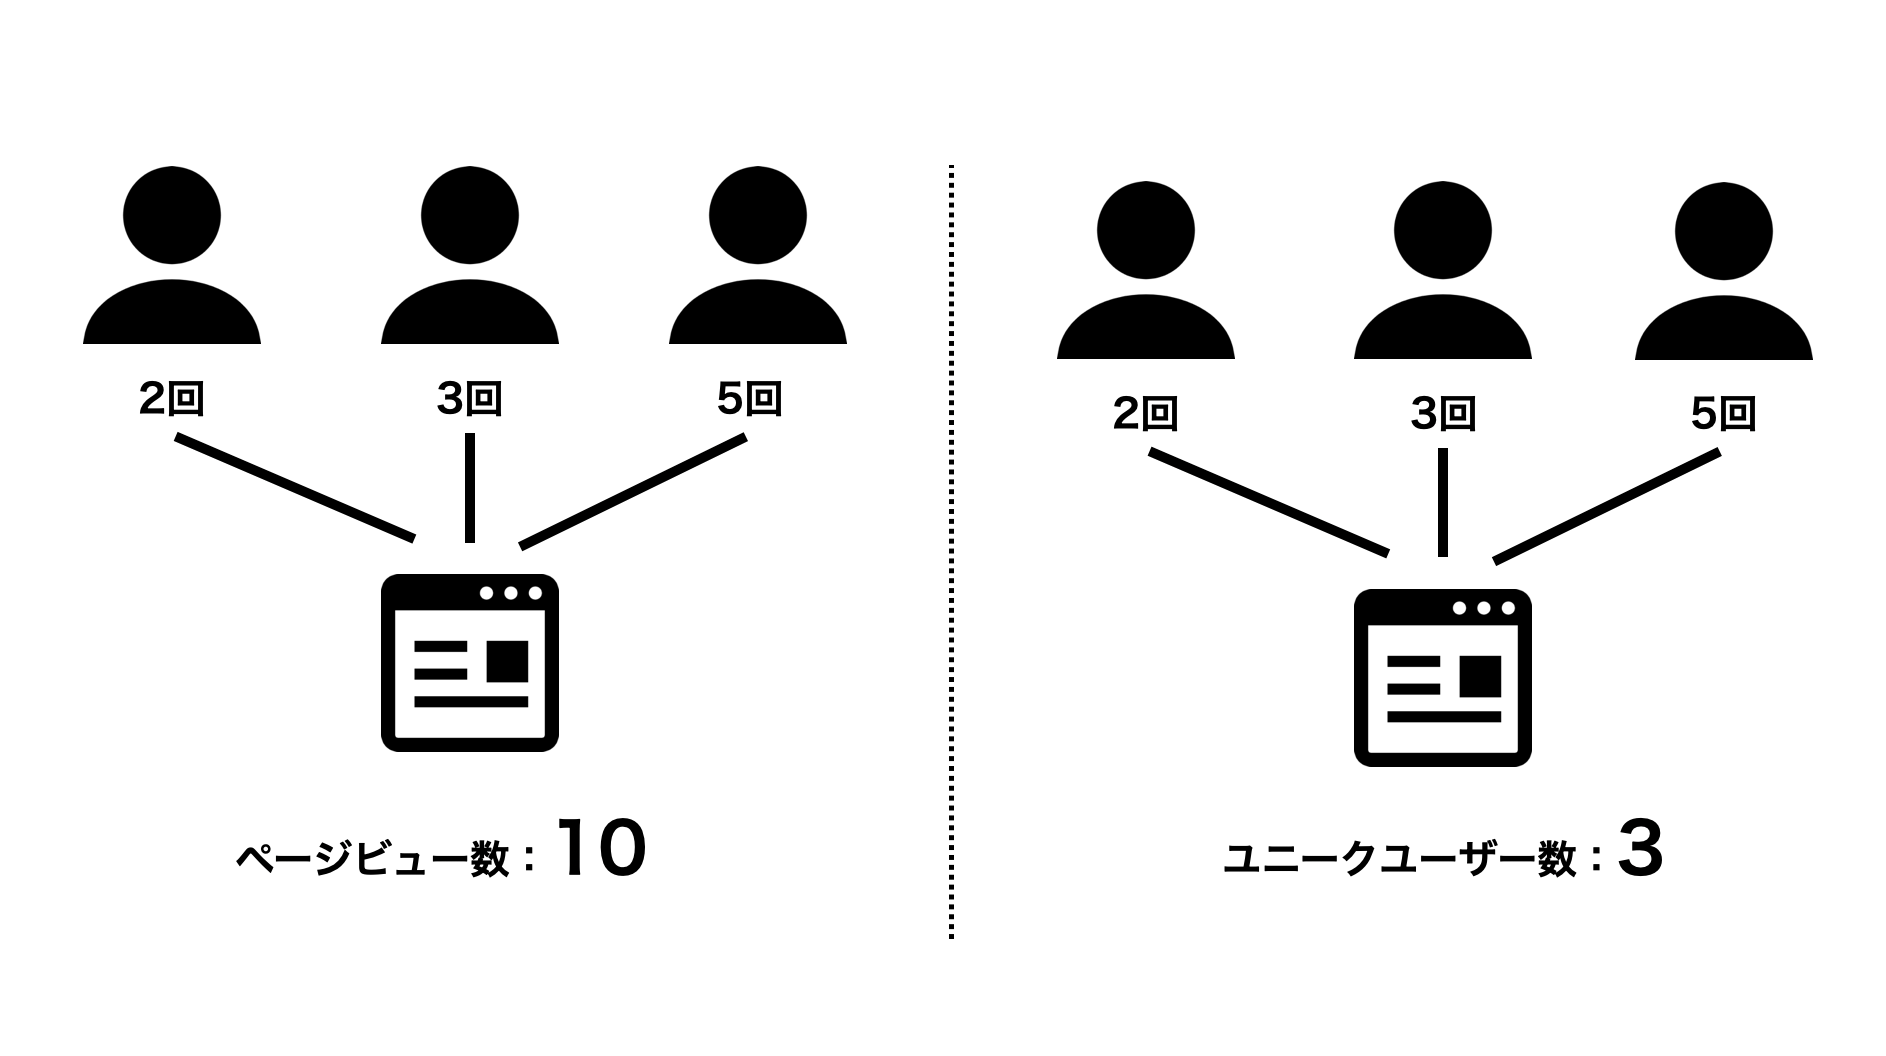
例えば、Webサービスでは、サイトのアクセス数としてページビュー数について知りたいときは、同じ人が複数回アクセスしても重複を排除せずに集計する必要があります。一方で、サイトに訪問したユニークユーザー数について知りたいときは、同じ人が複数回アクセスしたら重複を排除し、1人として集計する必要があります。
図4-15のように3人のユーザーがWebサイトにそれぞれ2回、3回、5回と訪問した場合は、すべてのサイトの訪問データを足して、ページビュー数は「10」になります。しかし、ユニークユーザー数を集計する場合は、それぞれのサイトの訪問データから重複を排除し、ユーザー数だけを集計の対象とすることで、結果は「3」になります。
・図4-15:ページビュー数とユニークユーザー数
このように、求めたいデータによって重複を排除して集計するのか、排除せずに集計するのか、使い分けが必要です。そこで、重複を排除して集計するときに使われるのがDISTINCTです。
DISTINCTの使い方を理解するために、まずはSQL4-14、SQL4-15を実行して出力結果を確認してみましょう。SQL4-14の出力結果を見ると、大カテゴリ(large_category)がすべて出力されています。これは重複を排除しない方法なので、同じ大カテゴリがあってもすべて出力されています。一方で、SQL4-15はlarge_categoryの前にDISTINCTがついています。カラム名の前にDISTINCTをつけることで、重複を排除して集計できます。この場合は同じ大カテゴリがあると重複を排除して、それぞれ1つずつ出力されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-14
SELECT
    large_category
FROM
products・表4-16:SQL4-14の実行結果
large_category |
|---|
食品 |
食品 |
食品 |
食品 |
食品 |
食品 |
食品 |
日用品 |
日用品 |
日用品 |
・・・ |
・SQL4-15
SELECT DISTINCT
    large_category
FROM
products・表4-17:SQL4-15の実行結果
large_category |
|---|
インテリア |
ファッション |
日用品 |
電化製品 |
食品 |
データ分析では、テーブルの中にどんなデータが入っているのか確認したいとき、DISTINCTを使うと非常に便利です。SQL4-15のように、商品情報テーブル(products)にどんな大カテゴリ(large_category)が入っているのか確認したいときは、DISTINCTを使うことで、大カテゴリの一覧を取得できます。
複数のカラムの組み合わせで重複を排除する
重複を排除するDISTINCTは、SELECTで複数のカラムを指定する場合でも活用できます。
SQL4-16を実行して出力結果を確認してみましょう。SQL4-16はlarge_category、medium_category、small_categoryの3つのカラムを組み合わせて、重複を排除した結果を出力しています。重複を排除したいカラムが1つの場合は、SQL4-15のように、1つのカラムを指定すれば問題ありません。重複を排除したいカラムが複数の場合は、SQL4-16のように、SELECTのあとにDISTINCTをつけて、カンマで区切ってカラムを複数指定することで、データを確認できます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-16
SELECT DISTINCT
    large_category,
    medium_category,
    small_category
FROM
products・表4-18:SQL4-16の実行結果
large_category | medium_category | small_category |
|---|---|---|
インテリア | 家具 | ソファ |
インテリア | 家具 | 台 |
インテリア | 家具 | 棚 |
インテリア | 家具 | 椅子 |
ファッション | アクセサリー | 時計 |
ファッション | カバン | トートバッグ |
ファッション | シューズ | パンプス |
ファッション | 衣服 | トップス |
ファッション | 衣服 | ワンピース |
ファッション | 衣服 | 靴下 |
・・・ | ・・・ | ・・・ |
集約関数と重複排除
DISTINCTは重複を排除するということから、集約関数と一緒に使われることも多いです。例えば、前述したユニークユーザー数が知りたいときは、集約関数とDISTINCTを活用することで集計できます。
SQL4-17を実行して出力結果を確認してみましょう。SQL4-17では、COUNTを使って3つの集計を行っています。COUNT(*)では、商品情報テーブルの行数を集計しています。COUNT(large_category)では、商品情報テーブルからlarge_categoryの件数を集計しており、large_categoryにNULLが含まれる場合は除外されます。本サイトのデータでは、large_categoryにNULLが含まれていないため、COUNT(*)とCOUNT(large_category)はどちらも同じ結果が出力されます。
一方で、COUNT(DISTINCT large_category)はlarge_categoryの前にDISTINCTがついています。カラム名の前にDISTINCTをつけることで、重複を排除した状態で行数が集計できます。その結果、large_categoryが全部で何種類あるのかが件数として出力されます。
★ハンズオン〜SQLを実行してみよう〜
・SQL4-17
SELECT
    COUNT(*) AS count_1,
    COUNT(large_category) AS count_2,
    COUNT(DISTINCT large_category) AS count_3
FROM
products・表4-19:SQL4-17の実行結果
count_1 | count_2 | count_3 |
|---|---|---|
60 | 60 | 5 |
このように、集約関数とDISTINCTを組み合わせることで、重複を排除してデータを集計できます。重複を排除して集計するのか、重複を排除せずに集計するのかは、どんなデータを集計したいかによって異なります。SQLを使ってデータ集計するときは、どんなデータを集計する必要があるか、定義を確認するのも重要です。どんなデータを集計したいのか確認したうえで、集約関数とDISTINCTをうまく活用しましょう。
データ分析における「集約関数」の考え方
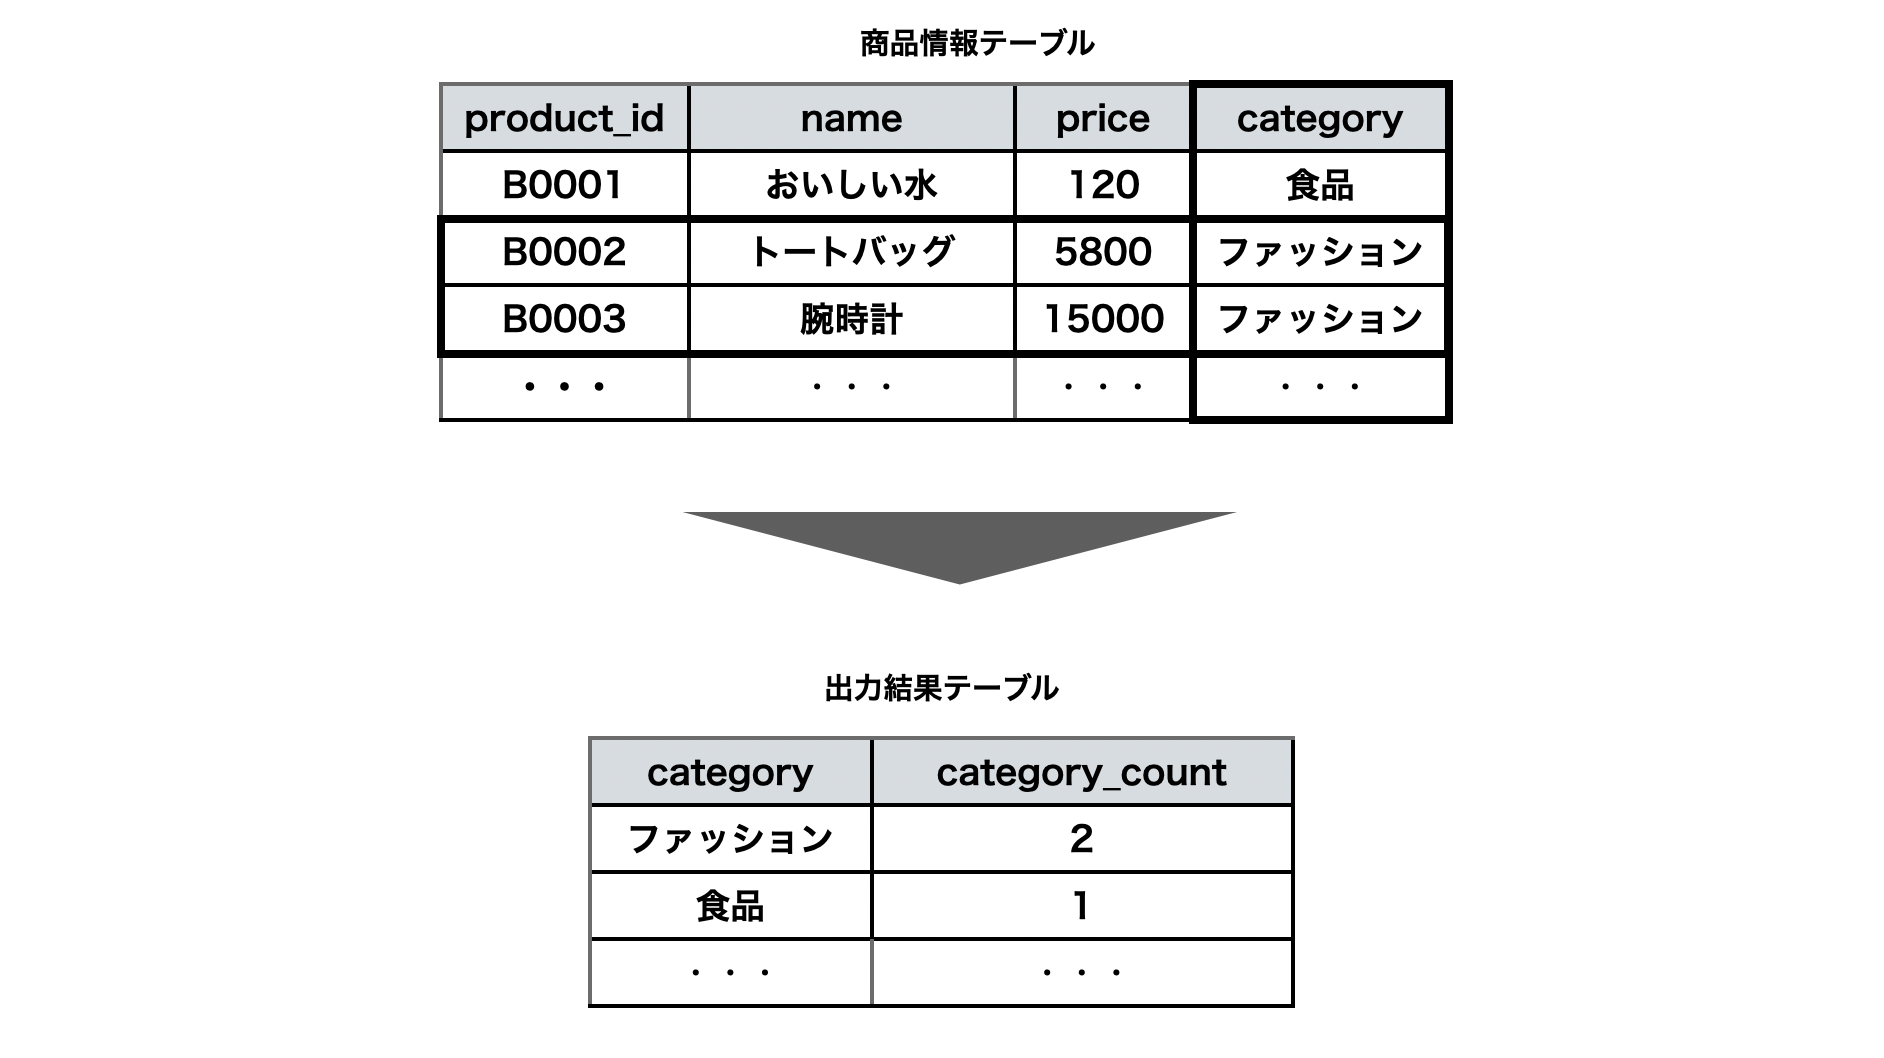
集約関数を使うことで、大量のデータをまとめて集計することができます。また、GROUP BYを使うことで、どんな軸でデータをまとめるのか指定することができます。図4-20のように、既存のテーブルから特定の切り口で行をまとめて1つの値にすることが集約関数で重要な考え方です。
データ分析では、データの件数を集計したり、最大値や平均値を求めることがよくあります。集約関数とGROUP BYを組み合わせて、カテゴリごとの商品件数や、日別の売上の合計など、さまざまな軸でデータをまとめることもあります。必要な集計に応じて、集約関数やGROUP BYなどをうまく活用しましょう。
・図4-20:集約関数の考え方
演習問題
演習問題4-1
顧客情報テーブル(users)から誕生年の最大値、最小値、平均値を出力してください。また、最大値、最小値、平均値はASで別名をつけて出力してください。
演習問題4-2
商品情報テーブル(products)から大カテゴリ(large_category)ごとの平均価格を取得してください。また、平均価格はASで別名をつけて出力してください。