
【SQL文法基礎1】大量のデータから必要なデータを取得する〜 SELECT / LIMIT / ORDER BY 〜
ここからは、SQLの基本的な構文を解説します。データを取得するときに使うSELECT文を中心に、SQLの構文について学んでいきましょう。
SQLの基本構文
SQLでよく使われるSELECT文
まずは、SQLの基本となるSELECT文を見てみましょう。SELECT文はSELECTから始まり、FROMやWHEREなどの句と呼ばれる要素を組み合わせて実行することで、データを取得することができます。データ分析では、SELECT文が最もよく活用されるため、本サイトで扱うSQLは基本的にSELECT文のことを指します(※1)。また、SQLやSELECT文のことをクエリとも呼びます。
(※1)SQLの構文にはデータを取得するSELECT文以外にも、データを更新するUPDATE文や、データを削除する DELETE 文などがあります。データ分析においてUPDATE 文やDELETE 文は使用頻度が低いため、本書では取り扱いません。本書ではより使用頻度の高いSELECT文に焦点を当てます。
第1章の「SQLの基本的な概念」で解説したとおり、SQLはデータベース上のテーブルに格納されたデータを取得するときに使う言語です。SQLの構文はSQLという言語を使って書かれた命令文の書き方のことです。つまり、SQLを使ったデータ分析をするためには、SQLの構文を理解する必要があります。
まずは、SQLの基本構文を理解するためにSQL3-1を見ながら全体像を解説します。詳細については次章以降で解説するので、ここではSQLの大枠だけ理解できれば問題ありません。
・SQLの基本構文
SELECT
    カラム名
FROM
    テーブル名
WHERE
    条件
GROUP BY
    グループ条件カラム
ORDER BY
並び順指定カラム・SQL3-1
SELECT
    large_category,
    COUNT(*)
FROM
    products
WHERE
    large_category = '食品'
GROUP BY
    large_category
ORDER BY
large_categorySELECT
SELECTは出力するデータを指定する句です。SQL3-1ではlarge_categoryとCOUNT(*)という2つのデータを取得しています。出力するデータには、テーブルのカラム(列)を指定したり、複数の行を計算してまとめた結果などを指定することができます。2つ以上のカラムを取得するときは、カンマ(,)をつけて複数記述します。複数の行をまとめて取得する方法は、第4章の「複数のデータを特定の切り口でまとめる」で解説します。
FROM
FROMはどのテーブルからデータを取得するのか指定する句です。SQL3-1では商品情報テーブル(products)からデータを取得しています。
WHERE
WHEREはデータを取得するときに条件をつける句です。SQL3-1ではWHERE large_category = '食品'という条件をつけて、大カテゴリ(large_category)の中から「食品」のデータだけを取得しています。WHEREの詳細については、第5章の「特定の条件をつけてデータを取得する」で解説します。
GROUP BY
GROUP BYは特定の切り口でデータを集計をするための句です。SQL3-1ではGROUP BY large_categoryというグループ条件を指定しているため、大カテゴリ(large_category)ごとのデータが集計されます。GROUP BYの詳細については、第4章の「複数のデータを特定の切り口でまとめる」で解説します。
ORDER BY
ORDER BYは出力結果の並び順を指定する句です。SQL3-1ではORDER BY large_categoryという並び順を指定しているため、大カテゴリ(large_category)の昇順で結果が出力されます。ORDER BYの詳細については、本章の「さまざまなデータの取得方法」で解説します。
SELECT文の実行
SQLの基本構文を理解したうえで、まずはSQL3-2を実行してみましょう。SQL3-2では、商品情報テーブル(products)にどんなデータが入っているかを確認し、商品ID(product_id)と商品名(name)を指定してデータを取得しています。
★ハンズオン〜SQLを実行してみよう〜
・SQL3-2
SELECT
    product_id,
    name
FROM
products・表3-1:SQL3-2の実行結果
product_id | name |
|---|---|
B000001 | 美味しい水 500ml |
B000002 | 美味しい水 2l |
B000003 | 美味しい水 2l 6本セット |
B000004 | パスタ 1kg |
B000005 | きゅうり 3本入り |
B000006 | トマト 大 |
B000007 | トマト 小 |
B000008 | 鉛筆 5本セット |
B000009 | 消しゴム |
B000010 | シャーペン |
・・・ | ・・・ |
このように、SELECT文を活用するときはどんなテーブルがあり、そのテーブルにはどんなカラムがあるのかを把握して、必要な情報を取得することが重要です。
SQLの基本的な考え方
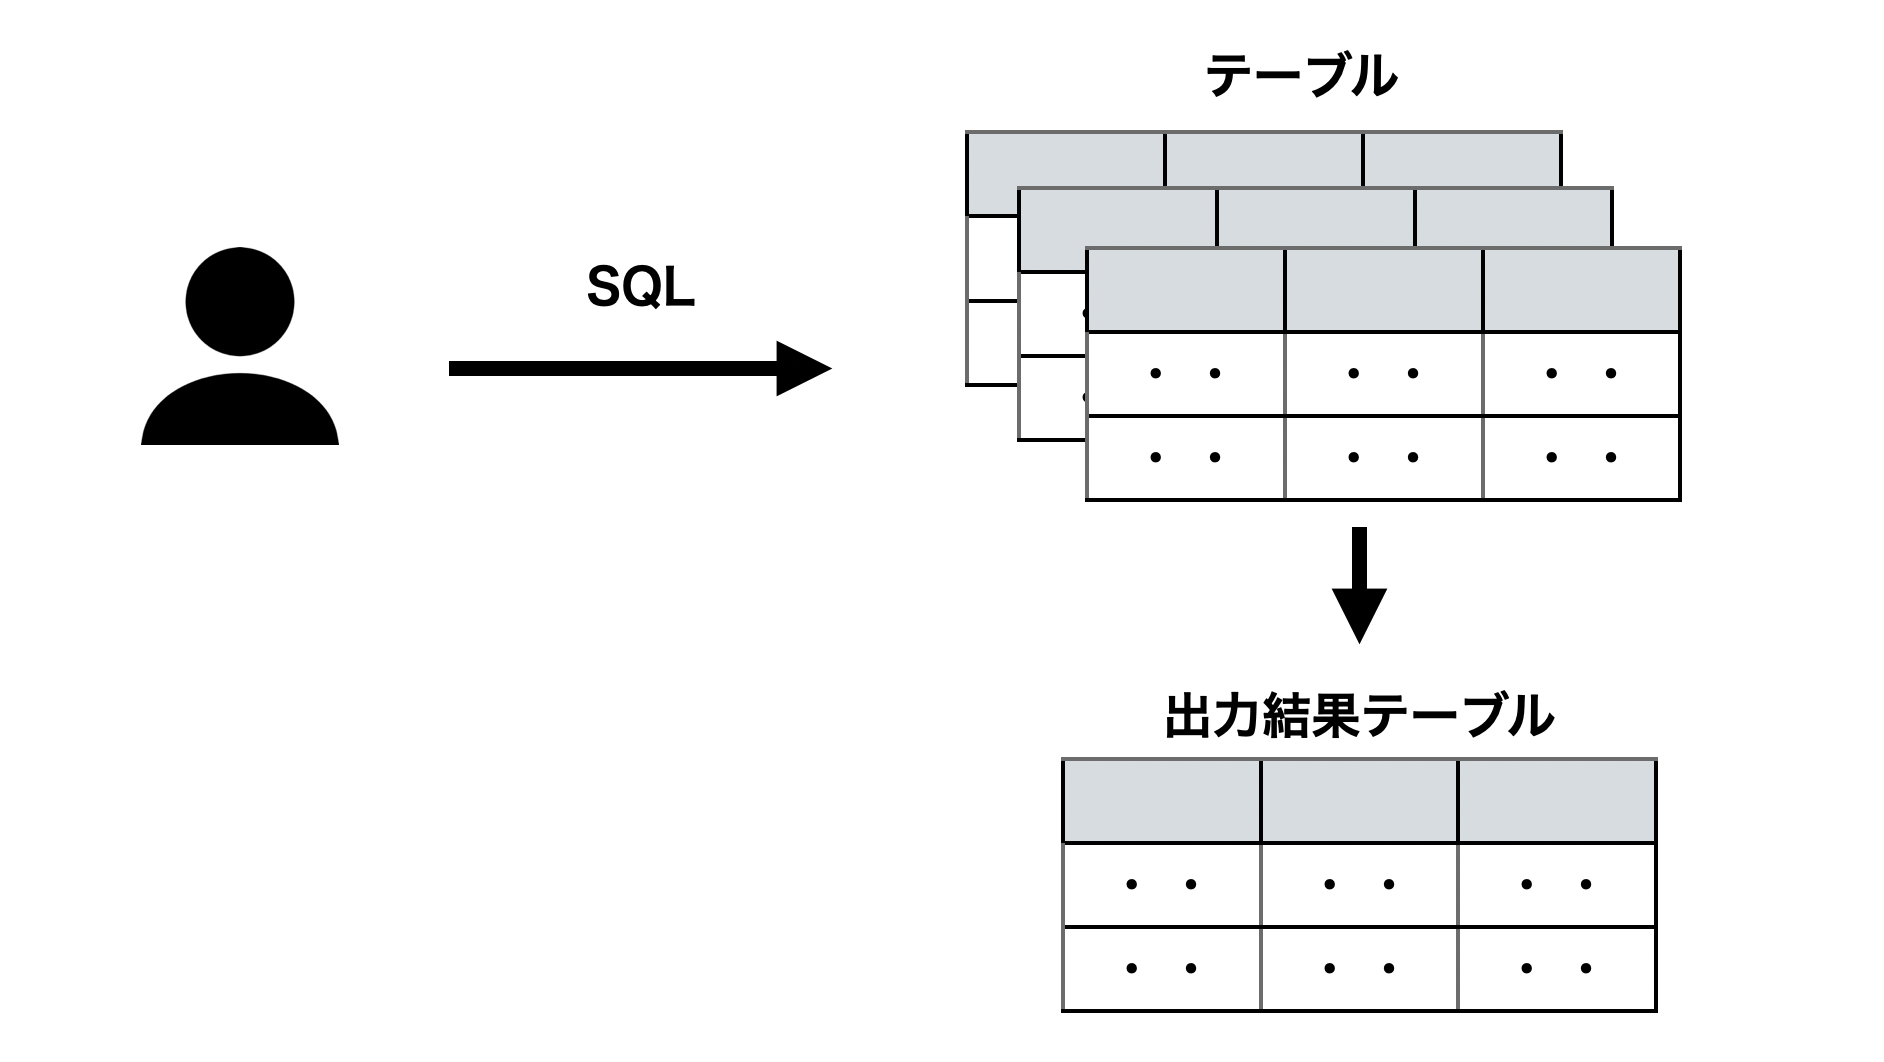
データ分析でSQLを実行するときは、第1章の「SQLの基本的な概念」で解説したテーブルの概念が重要です。つまり、SQLを実行するとは既存のテーブルをもとに新しいテーブルを作成することです。いろいろなデータがテーブルに存在している中で、どのテーブルの行あるいはカラムを取得するのか、どんな条件でデータを取得するのか、どのようにテーブルを組み合わせるのかを考えて、新しいテーブルを作成する。これがSQLを実行するということです。
このように、SQLを実行することで新しいテーブルが出力されるというイメージを持つと、どんなSQLを書く必要があるのか考えやすくなります。データ分析では、既存のテーブルをもとに新しいテーブルを作成するという考え方で、SQLを学んでいきましょう。
・図3-2:SQLの基本的な考え方
SQL記述の注意点
半角スペースと改行
SQLを書くときはSQL3-3やSQL3-4のようにSELECTやWHEREなどの間には半角スペースまたは改行を入れる必要があります。SQL3-5のように半角スペースや改行を入れずに連続して記述すると、データベースがSQLを解釈することができずに、エラーになります。また、半角スペースではなく、全角スペースの場合はエラーになってしまうので気をつけましょう。半角スペースや改行はどれだけ入れても大丈夫なので、誰が見てもSQLの内容がわかるように整形するのが一般的な書き方です。
また、SQLの最後にはセミコロン(;)を入れるのが一般的です。複数のSQLを同時に実行するときは、セミコロンでSQLを区切らないとエラーになります。ただし、SQLが1つだけのときは、セミコロンがなくても実行できる場合が多いです。本サイトで使用するSQLエディタや、他のSQLクライアントを使う場合も、SQLが1つだけのときはセミコロンがなくても問題ありません。したがって、本サイトの記載ではセミコロンを省略しています。
・SQL3-3(半角スペースが入っている)
SELECT large_category FROM products;・SQL3-4(改行が入っておりセミコロンが省略されている)
SELECT
large_category
FROM
products・SQL3-5(半角スペースが入っていない)
SELECTlarge_categoryFROMproducts大文字と小文字
SQLでは、基本的に大文字と小文字は区別されず、どちらで書いても同じ結果が得られます。ただし、SELECTやFROMなどの予約語は、大文字で書くという慣習があります。予約語とは、SQLを書くときにあらかじめ意味が定義されている言葉のことです。SELECT、FROM、COUNTなどは、SQLを書くときに特別な意味を持っている言葉としてあらかじめ定義されています。そのため、予約後はテーブル名やテーブルのカラム名にも使うことが出ないので、注意しましょう。
しかし、実際にデータ分析でSQLを書くときは、予約語を大文字で書くと手間になる場合があるため、すべて小文字で書くこともあります。予約語は小文字で書いても、エラーになることはありません。したがって、SQL3-6やSQL3-7のように大文字でも小文字でもわかりやすいほうで記述して問題ありません。本サイトでは、わかりやすさを重視して、予約語は大文字で記述します。
・SQL3-6(すべて小文字)
select large_category from products・SQL3-7(大文字と小文字が混ざっている)
SELECT large_category FROM productsコメント
SQLでは、どんな処理をしているのか日本語でコメントをつけることができます。単純なSQLであれば、見ただけでどんな処理をしているか解釈できますが、複雑になればなるほど、解釈も難しくなります。そのようなときは、SQLの中に日本語でコメントを書くことで、どんな処理をしているのか他の人が見ても解釈しやすいようにできます。SQL3-8のように1行のコメントであれば、ハイフン(-)を2つ連続でつけて、そのあとにコメントを入れます。また、複数行のコメントをつけるときは、SQL3-9のように/*から*/の間にコメントを入れます。
・SQL3-8(1行のコメント)
SELECT
    product_id, -- 商品ID
    name -- 商品名
FROM
products・SQL3-9(複数行のコメント)
/*
商品情報テーブルから必要なデータを取得する

products:商品情報テーブル
product_id:商品ID
name:商品名
*/

SELECT
    product_id,
    name
FROM
productsさまざまなデータの取得方法
データの型
SQLで取得できるテーブルのカラムには型が存在します。型とは、どんなデータが入っているのかをあらかじめ定義したものです。数字が入っているのか、文字列が入っているのかなど、さまざまなデータの型が存在します。型が決まると、そこには指定したデータの型しか入りません。例えば、数字を入れる型に文字列を入れることはできません。このように、データの型はあらかじめ決まっているため、データ分析をするときには、型に合わせてデータを取得しなければならない場合があります。データの型も重要な概念なので、理解しておきましょう。
データの型は扱うデータベースによって多少異なります。例えば、MySQLで扱うデータ型と、PostgreSQLで扱うデータ型は異なります。ただし、多くの場合どのデータベースでも同じようなデータ型を扱っているので、基本的なデータ型を理解しておけば問題ありません。今回は、PostgreSQLでよく使われる主要な型について紹介します。
INTEGER
「34」や「1500」などの整数を入れるデータ型です。ユーザーの年齢や商品の金額など、整数を入れるときにはINTEGERを使用します。
NUMERIC
「0.8」や「35.2」などの小数を入れるデータ型です。消費税や割合など、精度が必要な小数を扱うときはNUMERICまたはDECIMALを使用します(※2)。
(※2)PostgreSQLにはREALやDOUBLE PRECISIONという浮動小数点数の型もありますが、計算精度が重要な場面ではNUMERICやDECIMALを使うのが一般的です。
TEXT
「A0001」や「おいしい水」などの文字列を入れるデータ型です。ユーザーIDや商品名など、文字列を入れるときはTEXTを使用します。
NULL
NULLとは値が何もない、空の状態を意味します。NULLはデータ型ではなく、どのデータ型のカラムにも格納できる特殊な値です。データが存在しない・不明である場合にNULLが使われます。
BYTEA
Byte Arrayの略で、バイナリデータを保存できるデータ型です。画像、動画、実行ファイルなどを保存するときはBYTEAを使用します。
DATE / TIMESTAMP
DATEは「2023-05-15」のような日付を格納するデータ型で、TIMESTAMPは「2023-05-15 14:30:00」のように日付と時刻を合わせて格納するデータ型です。PostgreSQLではDATEとTIMESTAMPがネイティブの型として使用できます。本サイトのテーブルでも、注文日(order_date)や生年月日(birth_date)にはDATE型、会員登録日時(registered_at)にはTIMESTAMP型を使用しています。
BOOLEAN
TRUEまたはFALSEの真偽値を入れるデータ型です。PostgreSQLではBOOLEAN型がネイティブで使用できます。なお、本サイトのテーブルでは退会フラグ(is_deleted)や割引フラグ(is_discounted)など二択のフラグをINTEGER(0または1)で表しています。
すべてのデータを取得(アスタリスク)
SELECTを使うと、テーブルにあるカラム名を指定して必要なデータを取得できます。取得したいカラムが複数ある場合は、カンマをつけてデータを取得できますが、すべてのカラムを取得する方法も存在します。それがアスタリスク(*)を使用する方法です。
まずは、SQL3-10を実行して、どんな結果が得られるのか確認してみましょう。SQL3-10では、テーブルにあるカラムをすべて取得するアスタリスク(*)を使っています。SELECTのあとにアスタリスクを指定することで、テーブルにある情報をすべて取得できます。データ分析をするときに、どのテーブルにどのようなデータが入っているのか、データの中身を確認したいことはよくあります。そのようなときに、SELECT *を使って実際のデータを確認することができます。
★ハンズオン〜SQLを実行してみよう〜
・SQL3-10
SELECT
    *
FROM
products・表3-3:SQL3-10の実行結果
product_id | name | price | large_category | medium_category | small_category | is_active |
|---|---|---|---|---|---|---|
B000001 | 美味しい水 500ml | 59 | 食品 | 飲料水 | 水 | 1 |
B000002 | 美味しい水 2l | 120 | 食品 | 飲料水 | 水 | 1 |
B000003 | 美味しい水 2l 6本セット | 690 | 食品 | 飲料水 | 水 | 1 |
B000004 | パスタ 1kg | 399 | 食品 | 麺 | パスタ | 1 |
B000005 | きゅうり 3本入り | 159 | 食品 | 野菜 | きゅうり | 0 |
B000006 | トマト 大 | 250 | 食品 | 野菜 | トマト | 1 |
B000007 | トマト 小 | 150 | 食品 | 野菜 | トマト | 1 |
B000008 | 鉛筆 5本セット | 300 | 日用品 | 文房具 | 筆記用具 | 1 |
B000009 | 消しゴム | 100 | 日用品 | 文房具 | 筆記用具 | 1 |
B000010 | シャーペン | 150 | 日用品 | 文房具 | 筆記用具 | 1 |
・・・ | ・・・ | ・・・ | ・・・ | ・・・ | ・・・ | ・・・ |
ただし、SELECT *は注意して使う必要があります。アスタリスクを使うとすべてのカラムを取得するため、データ量が多くなり、処理が遅くなる場合があります。大量のデータを高速に処理できるSQLとはいえ、データの量が多くなればなるほどデータ取得の効率は下がります。例えば、テーブルのカラム数が全部で100以上あると、100列すべてを取得するのはかなり非効率です。そのため、SELECT *の使用はなるべく避けるのが、データ分析でも一般的です。
データの中身を確認したいときは、出力結果の件数を制限するLIMITを使うことで、処理が遅くならないようにすることができます。そのため、データの中身を確認したいときは、SELECT *とLIMITを使用することをおすすめします(LIMITの詳細については本章の「さまざまなデータの取得方法」で解説します)。
名前をつけてデータを取得(AS)
SQLを実行すると、結果として新しいテーブルが出力されます。出力結果テーブルでは、取得したデータがどんなデータなのか解釈がしやすいように、カラム名にわかりやすい名前をつけることができます。そのときに活用できるのが、ASを使って出力結果テーブルのカラム名に別名をつける方法です。
SQL3-11、SQL3-12を実行して、それぞれどんな結果が得られるのか確認してみましょう。SQL3-11では、SELECTで指定したカラムのあとにASをつけて、「商品ID」と「商品名」という別名をつけています。それによって、出力結果テーブルのカラム名もそれぞれ「商品ID」と「商品名」に変わります。同じようにSQL3-12では、ASを使って「id」と「na」という別名をつけており、出力結果テーブルのカラム名も「id」と「na」に変わっています。
★ハンズオン〜SQLを実行してみよう〜
・SQL3-11
SELECT
    product_id AS 商品ID,
    name AS 商品名
FROM
products・表3-4:SQL3-11の実行結果
商品ID | 商品名 |
|---|---|
B000001 | 美味しい水 500ml |
B000002 | 美味しい水 2l |
B000003 | 美味しい水 2l 6本セット |
B000004 | パスタ 1kg |
B000005 | きゅうり 3本入り |
B000006 | トマト 大 |
B000007 | トマト 小 |
B000008 | 鉛筆 5本セット |
B000009 | 消しゴム |
B000010 | シャーペン |
・・・ | ・・・ |
・SQL3-12
SELECT
    product_id AS id,
    name AS na
FROM
products・表3-5:SQL3-12の実行結果
id | na |
|---|---|
B000001 | 美味しい水 500ml |
B000002 | 美味しい水 2l |
B000003 | 美味しい水 2l 6本セット |
B000004 | パスタ 1kg |
B000005 | きゅうり 3本入り |
B000006 | トマト 大 |
B000007 | トマト 小 |
B000008 | 鉛筆 5本セット |
B000009 | 消しゴム |
B000010 | シャーペン |
・・・ | ・・・ |
このように、SELECTで指定したカラム名のあとにASをつけることで、出力結果テーブルのカラム名に別名をつけることができます。別名をつけるときは、日本語でも英語でも好きな文字を設定することができます。
集計結果の一部を素早く確認する
SQLの特徴の1つに、大量のデータを素早く取得できるというものがあります。SQLは数千万行、場合によって数億以上のデータを集計するときにも使われます。しかし、テーブルにあるすべてのデータを出力するのは非効率です。そこで活用されるのがLIMITです。LIMITを活用することで、集計結果の件数を制限してデータを取得することができます。
LIMITの使い方を理解するためにSQL3-13、SQL3-14を実行して、出力結果の違いを確認してみましょう。SQL3-13では、商品情報テーブルにあるすべての情報を出力しています。一方でSQL3-14では、LIMIT 5がついているため、商品情報テーブルから上位5件だけ出力されます。LIMITはSELECT文の一番最後に記述することで、出力結果の件数を制限することができます。
★ハンズオン〜SQLを実行してみよう〜
・SQL3-13
SELECT
    *
FROM
products・表3-6:SQL3-13の実行結果
product_id | name | price | large_category | medium_category | small_category | is_active |
|---|---|---|---|---|---|---|
B000001 | 美味しい水 500ml | 59 | 食品 | 飲料水 | 水 | 1 |
B000002 | 美味しい水 2l | 120 | 食品 | 飲料水 | 水 | 1 |
B000003 | 美味しい水 2l 6本セット | 690 | 食品 | 飲料水 | 水 | 1 |
B000004 | パスタ 1kg | 399 | 食品 | 麺 | パスタ | 1 |
B000005 | きゅうり 3本入り | 159 | 食品 | 野菜 | きゅうり | 0 |
B000006 | トマト 大 | 250 | 食品 | 野菜 | トマト | 1 |
B000007 | トマト 小 | 150 | 食品 | 野菜 | トマト | 1 |
B000008 | 鉛筆 5本セット | 300 | 日用品 | 文房具 | 筆記用具 | 1 |
B000009 | 消しゴム | 100 | 日用品 | 文房具 | 筆記用具 | 1 |
B000010 | シャーペン | 150 | 日用品 | 文房具 | 筆記用具 | 1 |
・・・ | ・・・ | ・・・ | ・・・ | ・・・ | ・・・ | ・・・ |
・SQL3-14
SELECT
    *
FROM
    products
LIMIT 5・表3-7:SQL3-14の実行結果
product_id | name | price | large_category | medium_category | small_category | is_active |
|---|---|---|---|---|---|---|
B000001 | 美味しい水 500ml | 59 | 食品 | 飲料水 | 水 | 1 |
B000002 | 美味しい水 2l | 120 | 食品 | 飲料水 | 水 | 1 |
B000003 | 美味しい水 2l 6本セット | 690 | 食品 | 飲料水 | 水 | 1 |
B000004 | パスタ 1kg | 399 | 食品 | 麺 | パスタ | 1 |
B000005 | きゅうり 3本入り | 159 | 食品 | 野菜 | きゅうり | 0 |
データ分析では大量のデータを扱うことが多いため、基本的にはSELECT * FROM テーブル名のようなすべてのデータを取得するSQLを使うのはあまりよくないとされています。むやみにすべてのデータを取得しようとすると、SQLの処理に時間がかかってしまうからです。
例えば、今回のように商品情報テーブルにどんなデータが入っているのか、データの具体的な中身について確認したい場合には、LIMITをつけることをおすすめします。LIMITをつけないとすべてのデータを取得することになるので、仮にそのテーブルにデータが数億件以上入っていると、それがすべて出力されることになり、SQLの処理にも時間がかかります。特に、すべてのデータを取得するアスタリスク(*)を使う場合には、出力するカラム情報もさらに増えるので、データの中身を確認したいときはSQLのLIMITと組み合わせて、データを取得することを意識しましょう。
集計結果の並べ替え
SQLで集計した結果は、基本的には並び順に規則性はありません。そこで、決まった並び順で結果を確認したいときは、ORDER BYを使うことで、SQLの結果を並び替えることができます。
SQL3-15、SQL3-16を実行して出力結果の違いを確認してみましょう。SQL3-15では、出力結果がどんな順番で出力されるのかは明示されていません。一方でSQL3-16では、ORDER BY price ASCという並び順が指定されています。この場合は商品の金額(price)が安い順に結果が出力されます。
ORDER BYを使うときは、どのカラムで並び替えるか、何順で並び替えるかの2つを指定する必要があります。SQL3-16ではORDER BY priceと記述してあるため、商品の金額(price)で並び替えるようになっています。何順で並び替えるかは、値が小さい順番で並び替えるのが昇順、値が大き順番で並び替えるかのが降順です。SQL3-16ではprice ASCと記述があるため、昇順で並び替えます。降順で並び替えたい場合は、ASCの代わりにDESCを使います。ASCとDESCは省力できますが、その場合はASCと同じ昇順で並び替えられます。
ORDER BY price ASC→ 昇順(小さい順)で並び替えORDER BY price DESC→ 降順(大きい順)で並び替えORDER BY price→ 昇順(小さい順)で並び替え
★ハンズオン〜SQLを実行してみよう〜
・SQL3-15
SELECT
    product_id,
    name,
    price
FROM
products・表3-8:SQL3-15の実行結果
product_id | name | price |
|---|---|---|
B000001 | 美味しい水 500ml | 59 |
B000002 | 美味しい水 2l | 120 |
B000003 | 美味しい水 2l 6本セット | 690 |
B000004 | パスタ 1kg | 399 |
B000005 | きゅうり 3本入り | 159 |
B000006 | トマト 大 | 250 |
B000007 | トマト 小 | 150 |
B000008 | 鉛筆 5本セット | 300 |
B000009 | 消しゴム | 100 |
B000010 | シャーペン | 150 |
・・・ | ・・・ | ・・・ |
・SQL3-16
SELECT
    product_id,
    name,
    price
FROM
    products
ORDER BY
price ASC・表3-9:SQL3-16の実行結果
product_id | name | price |
|---|---|---|
B000001 | 美味しい水 500ml | 59 |
B000009 | 消しゴム | 100 |
B000011 | ボールペン | 100 |
B000002 | 美味しい水 2l | 120 |
B000007 | トマト 小 | 150 |
B000010 | シャーペン | 150 |
B000005 | きゅうり 3本入り | 159 |
B000006 | トマト 大 | 250 |
B000008 | 鉛筆 5本セット | 300 |
B000019 | ボディソープ 300ml | 300 |
・・・ | ・・・ | ・・・ |
また、ORDER BYは複数のカラムを指定して並び替え条件を設定できます。
SQL3-17を実行して出力結果を確認してみましょう。SQL3-17では、ORDER BYのあとにprice DESCとlarge_category ASCの2つの並び替え条件が指定されています。これは、最初に商品の金額(price)を降順で並び替えたあと、大カテゴリ(large_category)を昇順で並び替えています。つまり、商品の金額で並び替えたときに、同じ金額があった場合は大カテゴリの名前で昇順に並び替えます。このように、ORDER BYはカンマ区切りで複数の並び替え条件を指定することができます。
★ハンズオン〜SQLを実行してみよう〜
・SQL3-17
SELECT
    product_id,
    name,
    price,
    large_category
FROM
    products
ORDER BY
    price DESC,
large_category ASC・表3-10:SQL3-17の実行結果
product_id | name | price | large_category |
|---|---|---|---|
B000044 | レザーソファ3人掛け | 35000 | インテリア |
B000050 | トートバッグ | 30000 | ファッション |
B000055 | ゲーム機 | 30000 | 電化製品 |
B000029 | 電子レンジ | 29000 | 日用品 |
B000057 | 美顔器 | 23000 | 電化製品 |
B000042 | 食器棚 横幅90cm | 22000 | インテリア |
B000041 | ペアグラス | 20000 | 日用品 |
B000049 | 腕時計 | 15000 | ファッション |
B000025 | ナイトクリーム | 15000 | 日用品 |
B000026 | 美容液 | 13000 | 日用品 |
・・・ | ・・・ | ・・・ | ・・・ |
ORDER BYの昇順と降順は、主に値が数字の場合に使われますが、文字列でも並び替えることができます。文字列の場合は、基本的に昇順があいうえお順(アルファベット順の辞書順)、降順がその逆という形で並び替えられます。ただし、文字列には平仮名、カタカナ、アルファベット、漢字などさまざまな文字が入ります。そのため、ORDER BYで文字列を並び替えるときは、意図した順番に並び替えがされているか十分に確認しましょう。
データ分析における「SELECT」の考え方
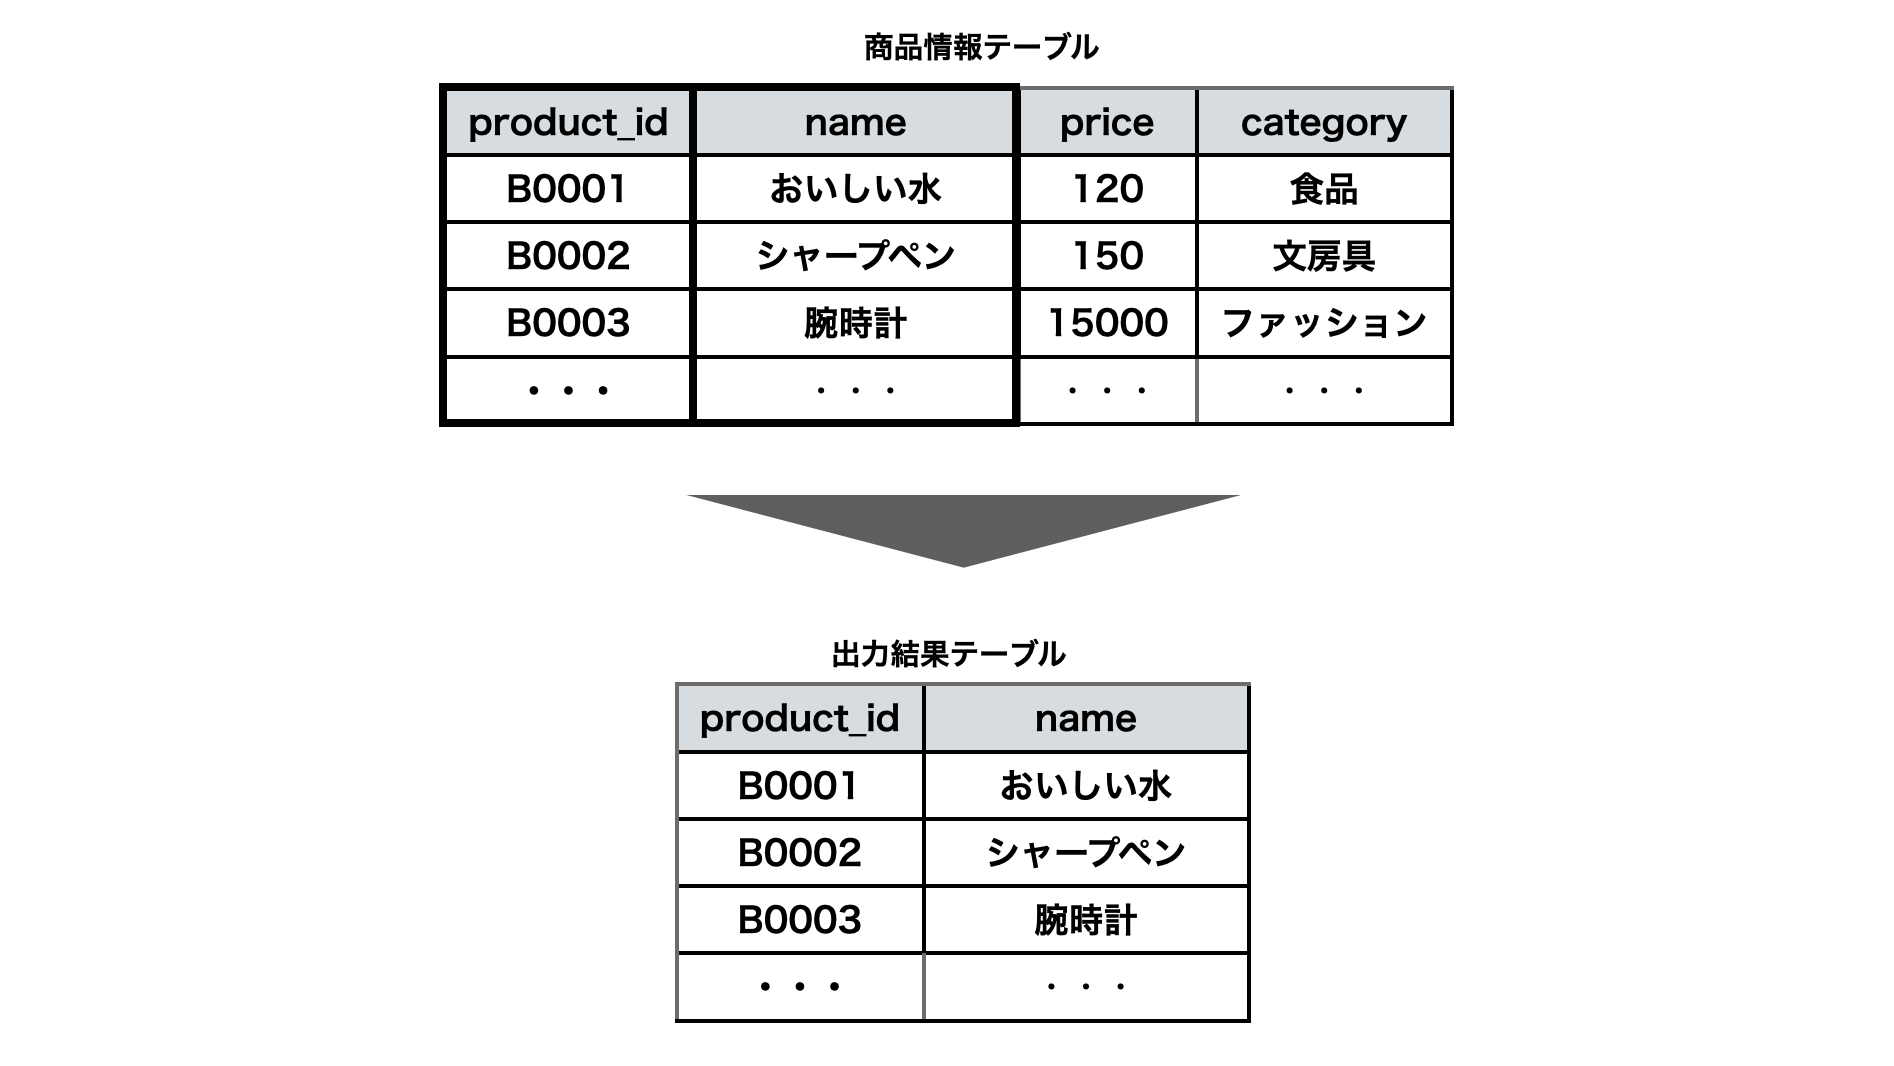
SELECTを使うことで、テーブルから必要なカラムを指定してデータを取得できます。すべてのカラムを取得するにはアスタリスク(*)を使いますが、基本的には必要なカラムを指定してデータを取得することが重要です。SQLの基本的な考え方で解説したとおり、SQLを実行するとは既存のテーブルをもとに新しいテーブルを作成することです。図3-11のように、既存のテーブルから必要なカラムだけの出力結果テーブルを求めることがSELECTで重要な考え方です。
また、SELECTで大事なことは、どんなテーブルが存在して、そのテーブルにどんなデータが入っているかを確認することです。一般的には、テーブル定義書と呼ばれるテーブルの情報をまとめたドキュメントがあることが多いので、その情報を確認しながらデータを取得しましょう。もしテーブル定義書がなければ、SELECT *とLIMITを活用して、テーブルにどんなデータが入っているのか確認することができます。本サイトのサンプルデータとして活用しているテーブル定義書は、第2章の「SQL実行のための環境構築」にあります。どのテーブルにどんなデータが入ってるか見たいときは、テーブル定義書を確認しましょう。
・図3-11:SELECTの考え方
演習問題
演習問題3-1
商品情報テーブル(products)からnameとlarge_categoryのデータを取得してください。また、nameは「商品名」、large_categoryは「カテゴリ」と別名をつけて出力してください。
演習問題3-2
顧客情報テーブル(users)から生年月日(birth_date)が大きい順に並び替えてユーザーID(user_id)と生年月日を出力してください。