
【SQL文法基礎8】複雑な集計をする〜 WINDOW関数 〜
これまでの章では、GROUP BYを使ってデータを集約する方法を学んできました。GROUP BYはとても便利な機能ですが、「集計した値を見ながら、元の行ごとの情報も同時に確認したい」という場面では、うまく使えないことがあります。本章では、そのような複雑な集計を可能にするWINDOW関数について学んでいきましょう。
WINDOW関数とは
通常の集計との違い
WINDOW関数を理解するために、まずGROUP BYを使った集計と何が違うのかを確認しましょう。
例えば、ユーザーごとの2023年の購入金額を集計することを考えます。GROUP BYを使うと、SQL10-1のように1ユーザー1行になった集計結果を取得することができます。
★ハンズオン〜SQLを実行してみよう〜
・SQL10-1
SELECT
    o.user_id,
    SUM(p.price) AS total_price
FROM
    orders AS o
    LEFT JOIN products AS p ON o.product_id = p.product_id
WHERE
    o.user_id IS NOT NULL
    AND o.order_date BETWEEN '2023-01-01' AND '2023-12-31'
    AND o.is_canceled = 0
GROUP BY
    o.user_id
ORDER BY
    total_price DESC
LIMIT 10・表10-1:SQL10-1の実行結果
user_id | total_price |
|---|---|
A000276 | 24712867 |
A000922 | 12462096 |
A000026 | 8425735 |
A000496 | 6035498 |
A000799 | 5676461 |
A000861 | 4527191 |
A000195 | 3662527 |
A000028 | 3008086 |
A000373 | 2618627 |
A000212 | 2453066 |
・・・ | ・・・ |
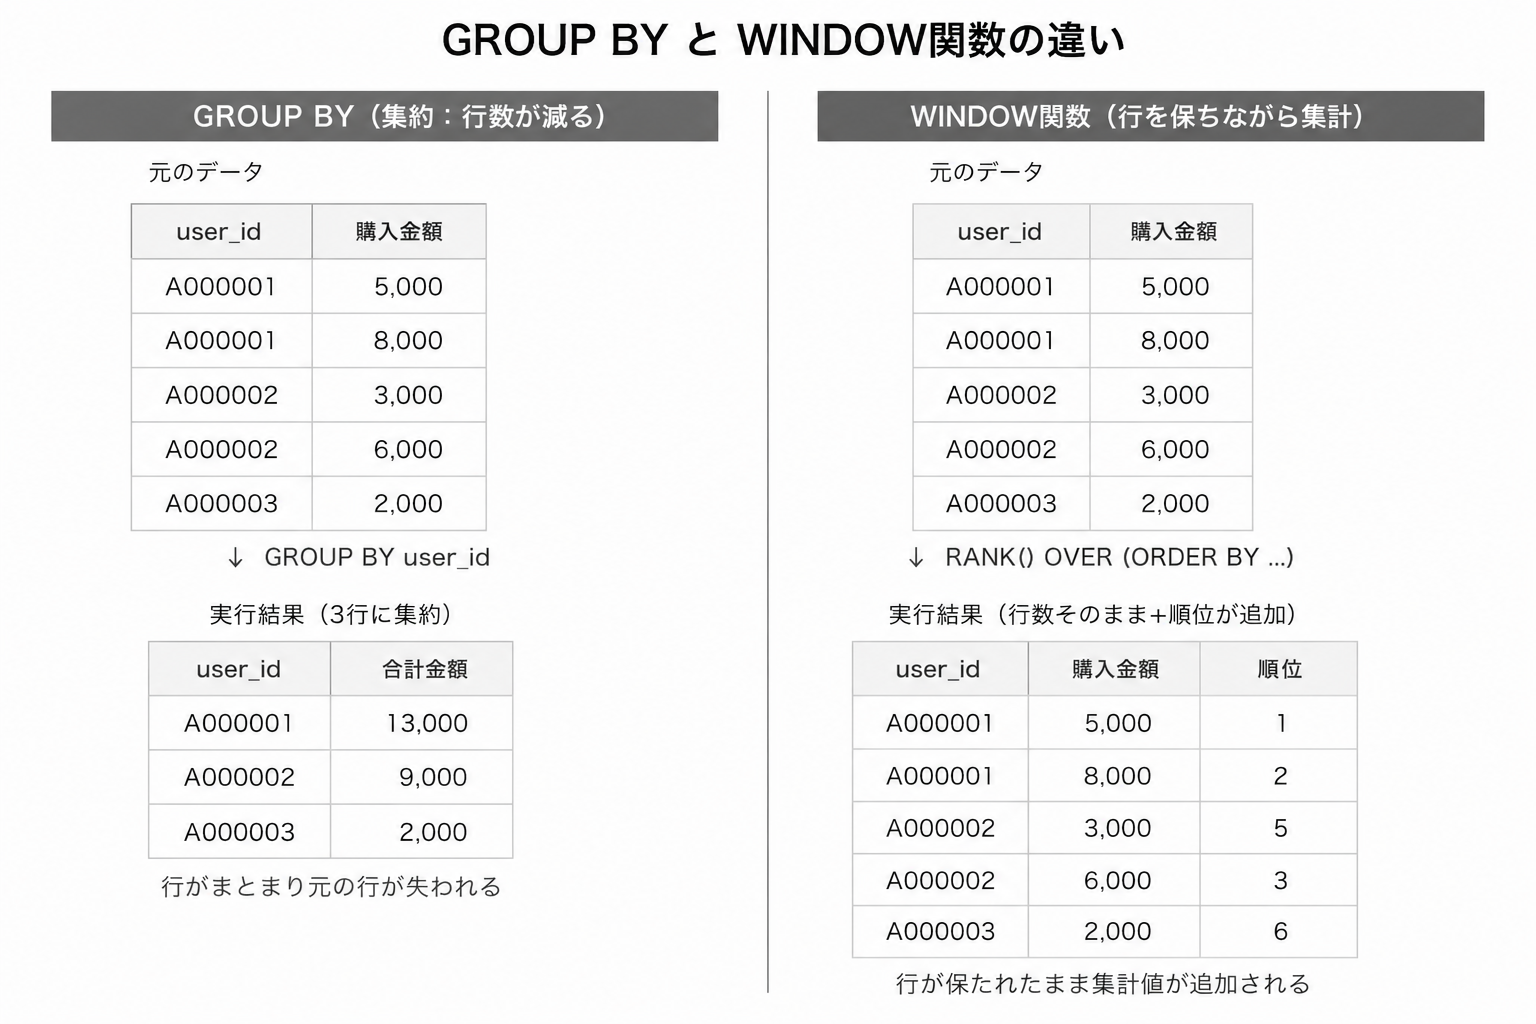
ここで「購入金額が多い順に順位をつけて表示したい」という要件が加わったとします。GROUP BYの結果には順位の情報がないため、この集計結果に対してさらにSQLを実行する必要があります。第9章で学んだサブクエリやWITH句を使えば実現できますが、シンプルな要件に対してSQLが複雑になってしまいます。
このような「各行に対して集計した値を付け加えたい」という場面で役に立つのがWINDOW関数です。WINDOW関数は、GROUP BYのように行をまとめることなく、各行を保ちながら集計や計算を行うことができる機能です。
・図10-2:GROUP BYとWINDOW関数の違い
WINDOW関数の基本構文
WINDOW関数は、SELECTの中で次のように記述します。関数名()のあとにOVERを続け、その中にどの範囲の行を対象にするかを指定します。このOVERの中で指定する範囲のことを「ウィンドウ(窓)」と呼ぶことから、WINDOW関数という名前がついています。
・WINDOW関数の基本構文
SELECT
    カラム名,
    関数名() OVER (ORDER BY カラム名) AS 別名
FROM
テーブル名OVERの中では、主に次の2つを指定します。
ORDER BY:どの順番で計算するかを指定します。順位をつけたいときはORDER BYで並び替えの基準を設定しますPARTITION BY:グループを分けて、グループごとに計算する場合に指定します(後述)
順位をつける〜RANK関数〜
RANK()の使い方
WINDOW関数の中でも、最もよく使われるのがRANK関数です。RANK()はデータに順位をつけることができる関数です。先ほどSQL10-1で集計したユーザーごとの購入金額に、RANK関数で順位をつけたのがSQL10-2になります。まずはSQL10-2を実行して出力結果を確認してみましょう。
★ハンズオン〜SQLを実行してみよう〜
・SQL10-2
SELECT
    o.user_id,
    SUM(p.price) AS total_price,
    RANK() OVER (ORDER BY SUM(p.price) DESC) AS rank
FROM
    orders AS o
    LEFT JOIN products AS p ON o.product_id = p.product_id
WHERE
    o.user_id IS NOT NULL
    AND o.order_date BETWEEN '2023-01-01' AND '2023-12-31'
    AND o.is_canceled = 0
GROUP BY
    o.user_id
ORDER BY
    rank
LIMIT 10・表10-3:SQL10-2の実行結果
user_id | total_price | rank |
|---|---|---|
A000276 | 24712867 | 1 |
A000922 | 12462096 | 2 |
A000026 | 8425735 | 3 |
A000496 | 6035498 | 4 |
A000799 | 5676461 | 5 |
A000861 | 4527191 | 6 |
A000195 | 3662527 | 7 |
A000028 | 3008086 | 8 |
A000373 | 2618627 | 9 |
A000212 | 2453066 | 10 |
・・・ | ・・・ | ・・・ |
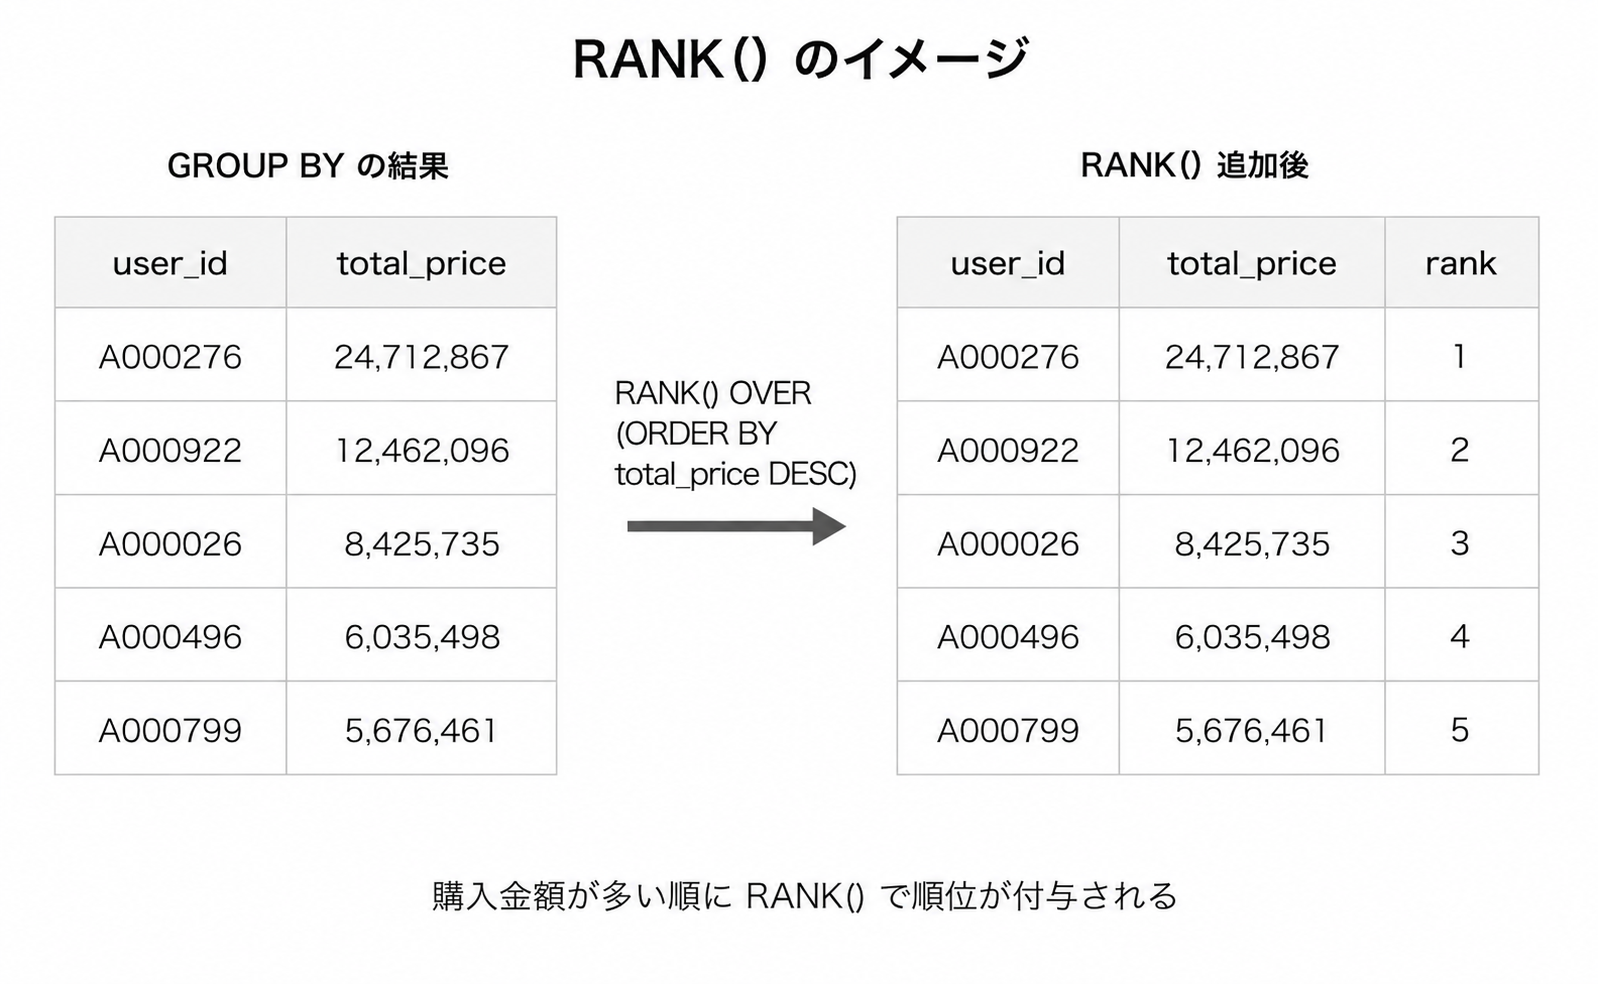
SQL10-1と比較すると、rankというカラムが追加され、購入金額の多い順に1位、2位……と順位がつきました。RANK() OVER (ORDER BY SUM(p.price) DESC)の部分がWINDOW関数の記述です。OVERの中にORDER BY SUM(p.price) DESCと指定することで、購入金額(total_price)が多い順に順位を計算しています。
重要なポイントは、GROUP BY o.user_idで集約しているにもかかわらず、rankカラムには各ユーザーの順位が付いているという点です。このように、WINDOW関数は集計後の各行に対して計算を追加できるため、GROUP BYとの組み合わせで非常に便利に使えます。
・図10-4:RANKのイメージ
RANK()とDENSE_RANK()の違い
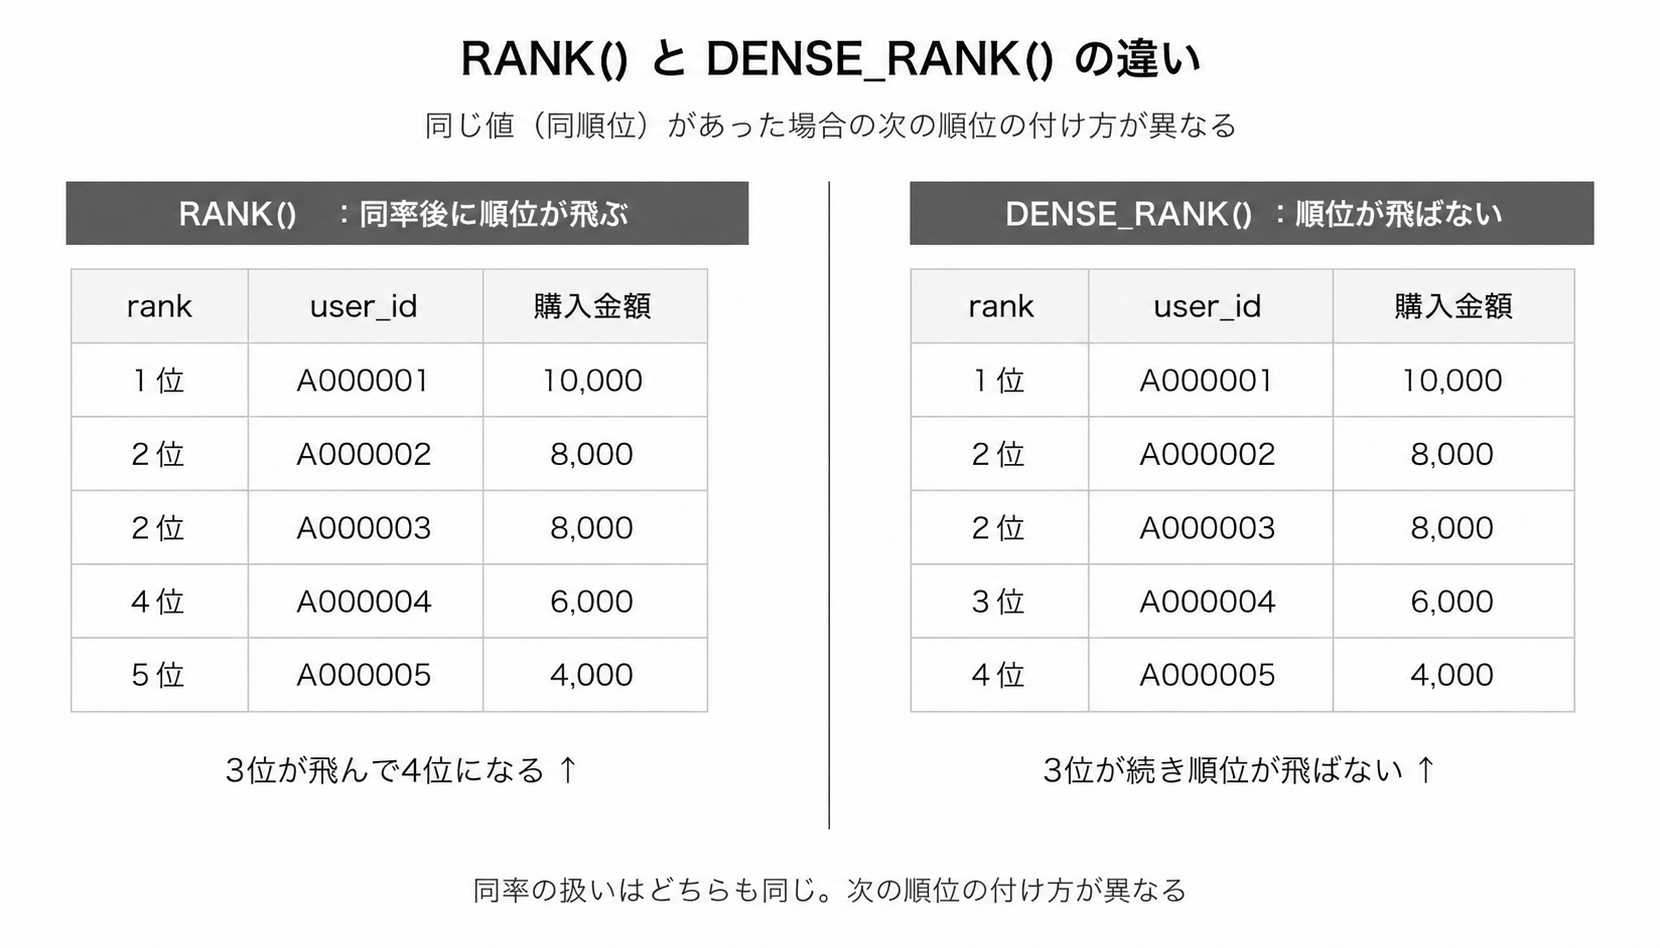
RANK関数に似た関数としてDENSE_RANK() があります。2つの違いは、同じ値(同順位)があったときの次の順位の付け方にあります。
例えば、2位が2人いた場合を考えてみましょう。RANK()は、2位が2人いたら次の順位は「4位」になります(3位が飛ばされます)。一方、DENSE_RANK()は、2位が2人いても次の順位は「3位」になります(順位が飛ばされません)。
・図10-5:RANK()とDENSE_RANK()の違い
どちらを使うかは分析の目的によります。「売上上位5社に何社入っているか」のように同率を1つの順位として数えたいときはDENSE_RANK()が便利です。一方、「全体で何番目に位置するか」を正確に示したいときはRANK()が適しています。
グループ内で順位をつける〜PARTITION BY〜
PARTITION BYとは
WINDOW関数のOVERの中で指定できるPARTITION BYは、グループを分けてグループ内で計算を行うための指定です。GROUP BYと似た名前ですが、PARTITION BYはWINDOW関数のための区切りを定義するだけで、行をまとめることはありません。
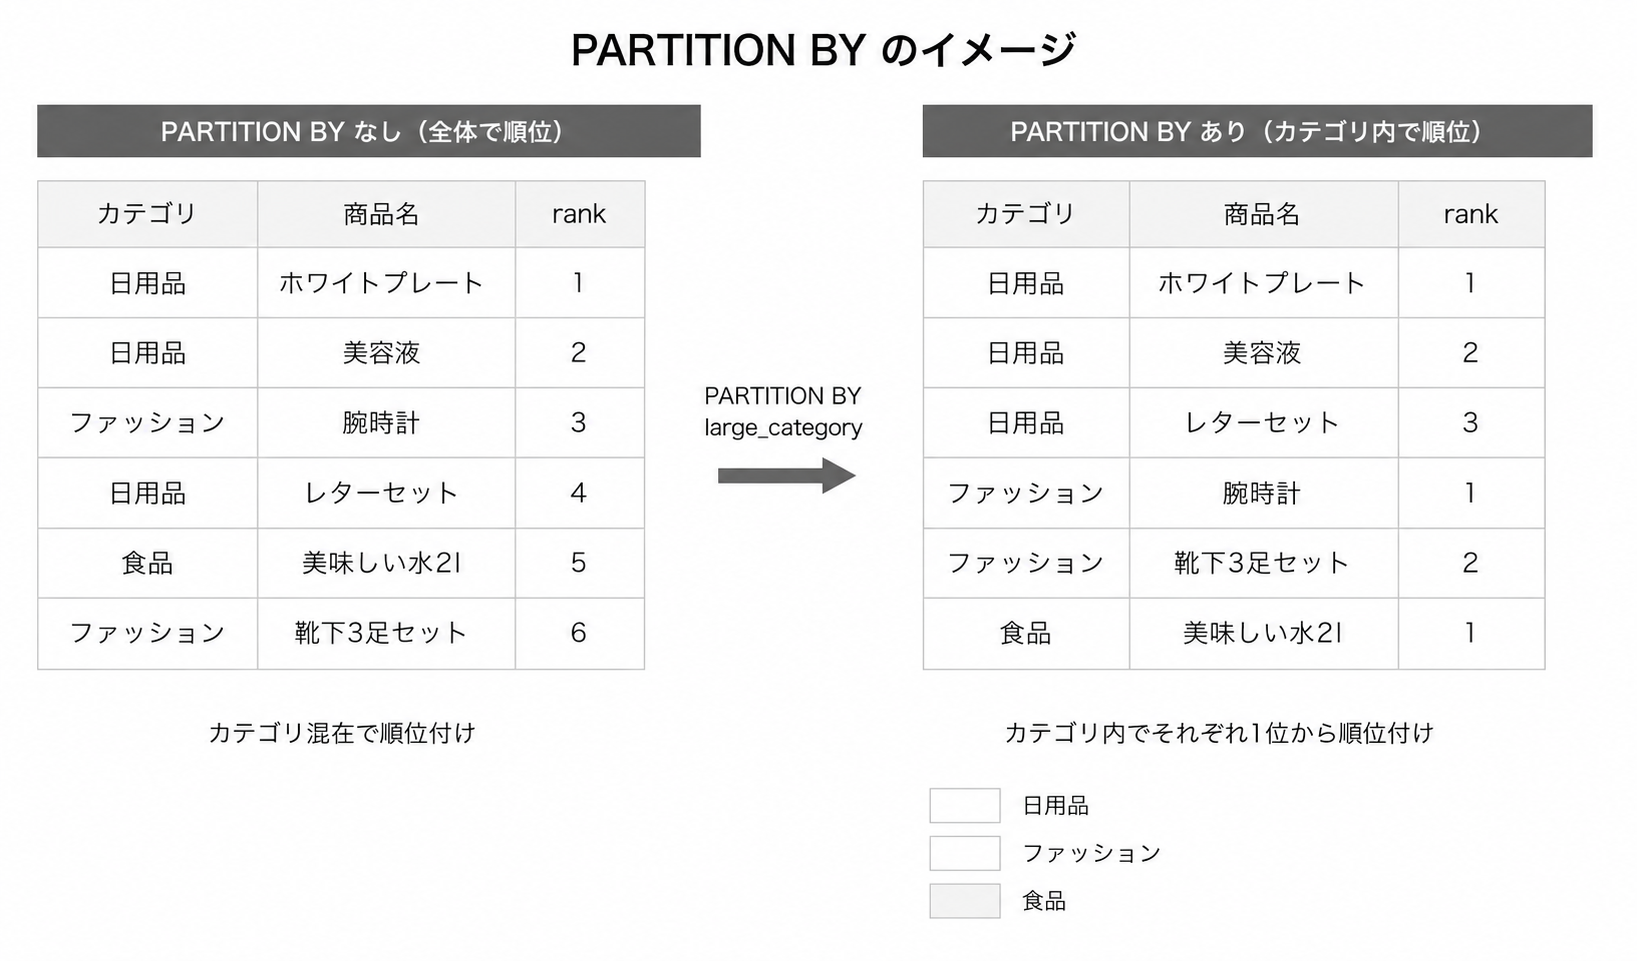
例えば、「大カテゴリ別に商品の人気ランキングを出したい」という場合を考えてみましょう。カテゴリをまたいで全商品をランキングしてしまうと、注文件数の多い日用品ばかりが上位を占めてしまいます。PARTITION BYを使えば、「日用品の中での1位、2位、3位……」「食品の中での1位、2位、3位……」というように、カテゴリの中での順位を計算できます。
・図10-6:PARTITION BYのイメージ
PARTITION BYの使い方
実際にPARTITION BYを使って、大カテゴリ内での商品ランキングを集計したのがSQL10-3になります。まずはSQL10-3を実行して出力結果を確認してみましょう。第9章で学んだWITH句を使って、商品ごとの注文件数を先に集計してから、RANK() OVER (PARTITION BY ...)でランキングをつけています。
★ハンズオン〜SQLを実行してみよう〜
・SQL10-3
WITH product_counts AS (
    SELECT
        p.large_category,
        p.name,
        COUNT(o.order_id) AS order_count
    FROM
        orders AS o
        LEFT JOIN products AS p ON o.product_id = p.product_id
    WHERE
        o.is_canceled = 0
    GROUP BY
        p.large_category,
        p.name
)

SELECT
    large_category,
    name,
    order_count,
    RANK() OVER (PARTITION BY large_category ORDER BY order_count DESC) AS rank
FROM
    product_counts
ORDER BY
    large_category,
rank・表10-7:SQL10-3の実行結果
large_category | name | order_count | rank |
|---|---|---|---|
インテリア | レザーソファ3人掛け | 788 | 1 |
インテリア | テレビ台 150cm | 733 | 2 |
インテリア | デスクチェア | 367 | 3 |
ファッション | 腕時計 | 2404 | 1 |
ファッション | 靴下3足セット | 1461 | 2 |
ファッション | トートバッグ | 698 | 3 |
日用品 | ホワイトプレート22cm | 27781 | 1 |
日用品 | 美容液 | 13623 | 2 |
日用品 | レターセット | 8347 | 3 |
電化製品 | DVD 10枚セット | 5883 | 1 |
・・・ | ・・・ | ・・・ | ・・・ |
出力結果を確認すると、大カテゴリ(large_category)の中で、注文件数(order_count)の多い順に1位、2位……と順位(rank)がついているのが確認できます。インテリアの中での1位は「レザーソファ3人掛け」、ファッションの中での1位は「腕時計」というように、カテゴリをまたいだ順位ではなく、各カテゴリ内での順位になっています。
SQL10-3のRANK() OVER (PARTITION BY large_category ORDER BY order_count DESC)の部分がWINDOW関数の記述です。PARTITION BY large_categoryと指定することで、large_categoryの値ごとにグループを分け、その中でORDER BY order_count DESCに基づく順位を計算しています。
このように、PARTITION BYを使うと、グループの区切りを定義しながら各行に計算結果を付け加えることができます。GROUP BYでは行がまとまってしまうのに対し、PARTITION BYを使ったWINDOW関数では元の行がそのまま残り、カテゴリ内の順位だけが追加されているのが重要なポイントです。
累計を計算する〜SUM() OVER()〜
SUM() OVER()の使い方
WINDOW関数は順位をつける以外にも、累計(累積合計)を計算するときにも便利です。SUM()をWINDOW関数として使う場合は、SUM(カラム名) OVER (ORDER BY カラム名)のように記述します。
例えば、「月ごとの売上金額を確認しながら、1月からの累計売上も同時に見たい」という場合を考えてみましょう。SQL10-4では、WITH句を使って月ごとの売上を先に集計してから、SUM() OVER (ORDER BY month)で累計を計算しています。まずはSQL10-4を実行して出力結果を確認してみましょう。
★ハンズオン〜SQLを実行してみよう〜
・SQL10-4
WITH monthly_revenue AS (
    SELECT
        TO_CHAR(o.order_date, 'YYYY-MM') AS month,
        SUM(p.price) AS monthly_revenue
    FROM
        orders AS o
        LEFT JOIN products AS p ON o.product_id = p.product_id
    WHERE
        o.order_date BETWEEN '2023-01-01' AND '2023-12-31'
        AND o.is_canceled = 0
    GROUP BY
        TO_CHAR(o.order_date, 'YYYY-MM')
)

SELECT
    month,
    monthly_revenue,
    SUM(monthly_revenue) OVER (ORDER BY month) AS cumulative_revenue
FROM
    monthly_revenue
ORDER BY
month・表10-8:SQL10-4の実行結果
month | monthly_revenue | cumulative_revenue |
|---|---|---|
2023-01 | 15984704 | 15984704 |
2023-02 | 14111551 | 30096255 |
2023-03 | 16807339 | 46903594 |
2023-04 | 15323752 | 62227346 |
2023-05 | 15645469 | 77872815 |
2023-06 | 15385603 | 93258418 |
2023-07 | 16251055 | 109509473 |
2023-08 | 15324931 | 124834404 |
2023-09 | 15128303 | 139962707 |
2023-10 | 15968527 | 155931234 |
2023-11 | 15352728 | 171283962 |
2023-12 | 16922547 | 188206509 |
出力結果を確認すると、monthly_revenueが月ごとの売上金額、cumulative_revenueが1月から各月までの累計売上金額になっています。例えば、2023年2月のcumulative_revenueは「15,984,704(1月)+ 14,111,551(2月)= 30,096,255」になっているのが確認できます。
SUM(monthly_revenue) OVER (ORDER BY month)の部分がWINDOW関数の記述です。ORDER BY monthと指定することで、月の昇順(1月、2月、3月……)に沿って、その行までの合計値を計算しています。このようにWINDOW関数のSUM()は、全体の合計ではなく、指定した順序に従って行ごとに累積した合計を返します。
・図10-9:SUM() OVER()のイメージ
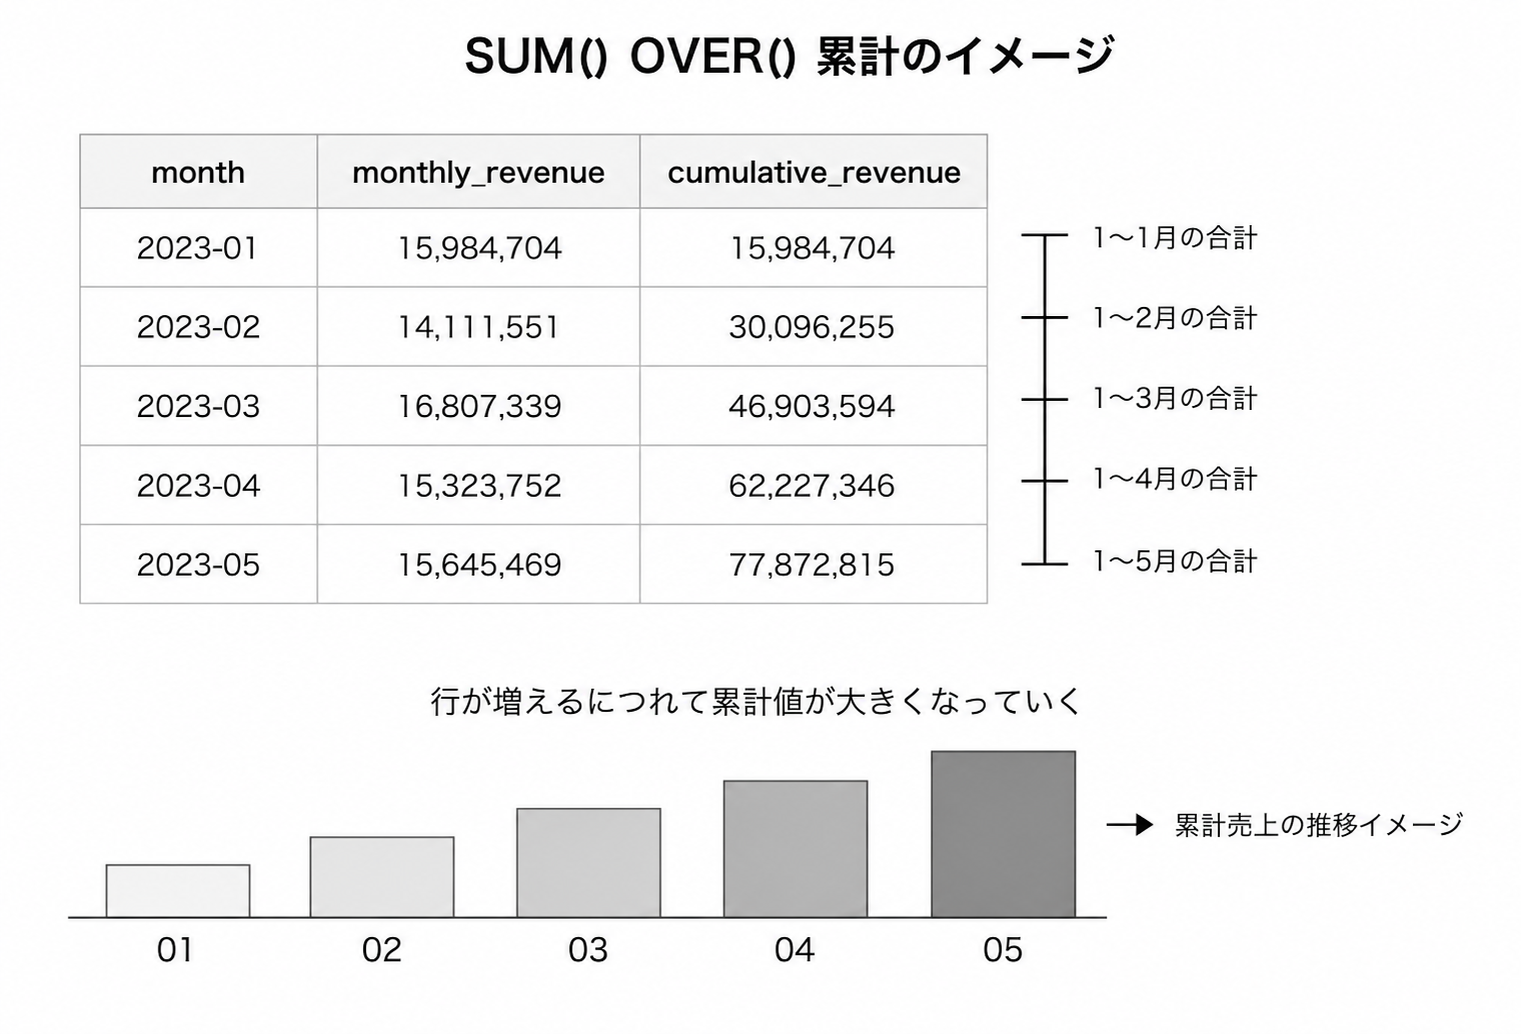
累計を計算するSUM() OVER()は、売上のトレンド把握や予算達成率の確認など、実務のデータ分析でも頻繁に登場します。「月次の売上を見ながら、年間目標に対してどのくらい進んでいるか」を確認したい場面などで大変役立ちます。
その他のWINDOW関数
ROW_NUMBER()
RANK()と似た関数としてROW_NUMBER() があります。ROW_NUMBER()は各行に対してユニークな連番(行番号)を付与します。RANK()と異なる点は、同じ値があっても必ず異なる番号が割り当てられることです。
・RANK()とROW_NUMBER()の比較
購入金額 | RANK() | ROW_NUMBER() |
|---|---|---|
24712867 | 1 | 1 |
12462096 | 2 | 2 |
8425735 | 3 | 3 |
8425735 | 3 | 4 |
5676461 | 5 | 5 |
上の例のように、同じ購入金額が2件ある場合、RANK()では両方とも「3位」になりますが、ROW_NUMBER()では「3」と「4」という異なる番号が付与されます。ROW_NUMBER()は「上位N件だけデータを取得したい」という絞り込みに使うことが多いです。
WINDOW関数には他にも、前の行の値を参照できるLAG()や、後の行の値を参照できるLEAD()などがあります。データ分析の現場では、RANK()・DENSE_RANK()・SUM() OVER()の3つが特によく使われるので、まずはこれらを押さえておきましょう。
データ分析におけるWINDOW関数の考え方
WINDOW関数の最大の特徴は、行を集約せずに集計結果を各行に付け加えられる点です。GROUP BYを使うと行数が減るため、元のデータと組み合わせて分析したいときはサブクエリやWITH句が必要でした。WINDOW関数を使えば、そのような複雑な記述をしなくても、1つのSQLで集計値を各行に付け加えることができます。
・図10-10:WINDOW関数の考え方
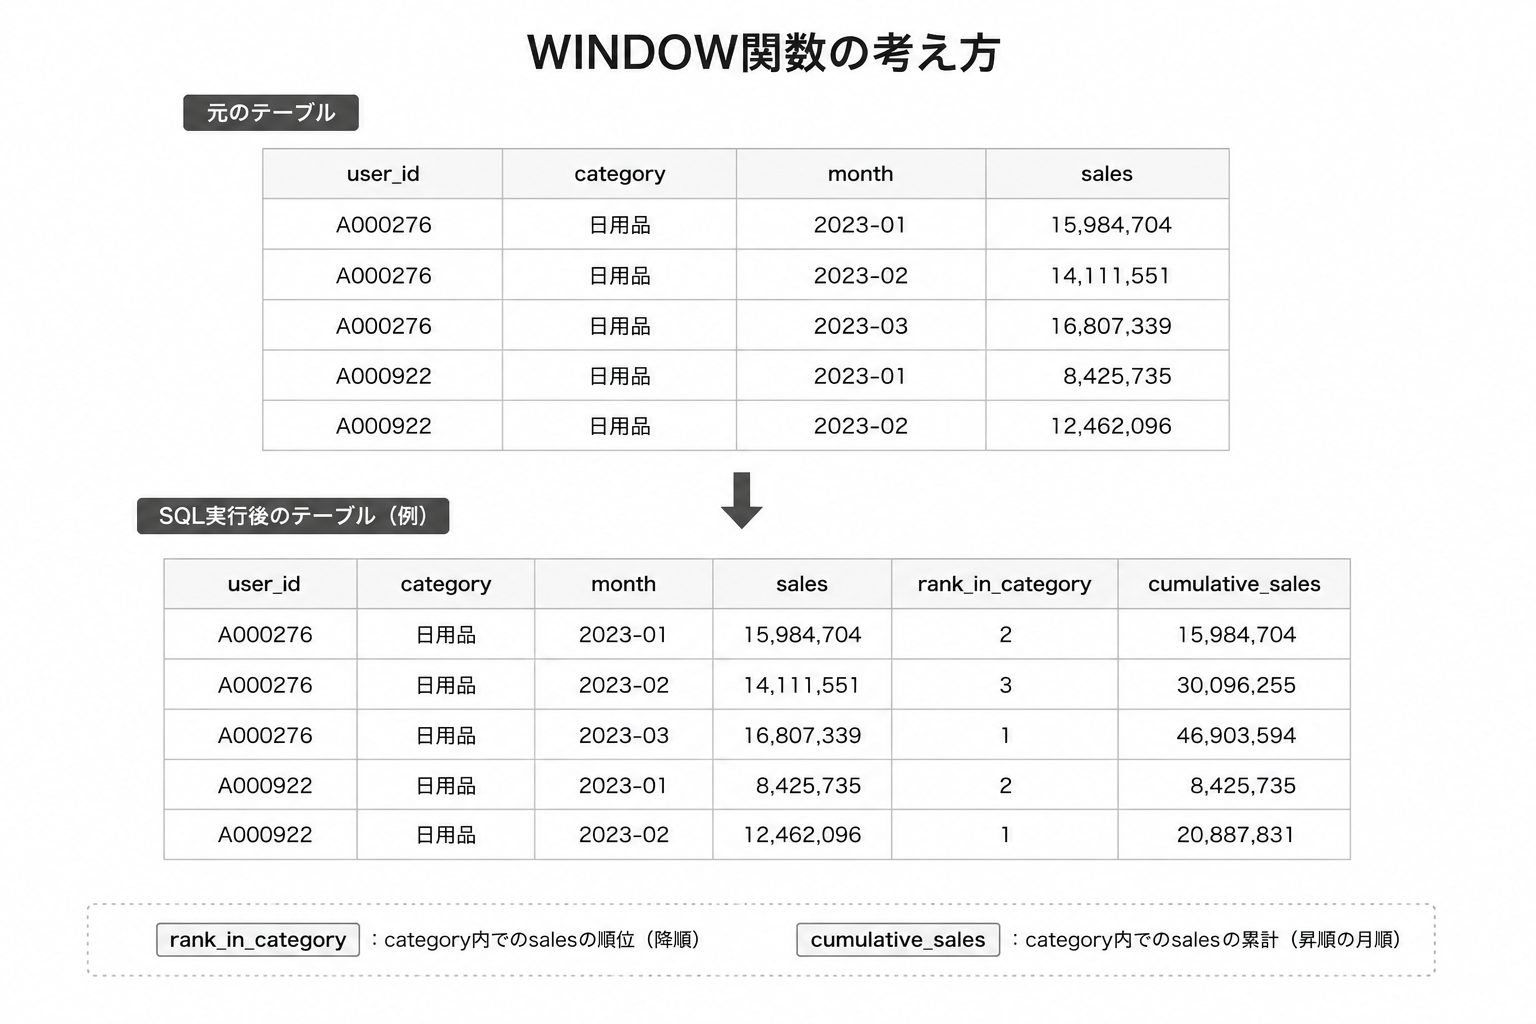
WINDOW関数は、次のような場面で特に力を発揮します。
- 順位付け:売上ランキング、ユーザーの貢献度ランキングなど
- グループ内順位:カテゴリ内での人気商品ランキング、地域別の集計順位など
- 累計計算:月次売上の累計、目標達成率の推移など
データ分析の現場でも、WINDOW関数を使いこなせると、複雑な集計が一段とシンプルに書けるようになります。GROUP BYや第9章のサブクエリ・WITH句と組み合わせて活用することで、より高度なデータ分析ができるようになります。ぜひ積極的に使ってみてください。
演習問題
演習問題10-1
2023年の年間購入金額が多い順に上位5位までのユーザーIDと購入金額、順位を取得してください。また、ユーザー情報が空のデータとキャンセルされた購入データは除外してください。
演習問題10-2
第9章で学んだWITH句とWINDOW関数を組み合わせて、2023年の月ごとの売上金額と、1月からの累計売上金額を計算してください。ただし、キャンセルされた購入データは除外してください。